카테고리 보관물: IT&최신기술

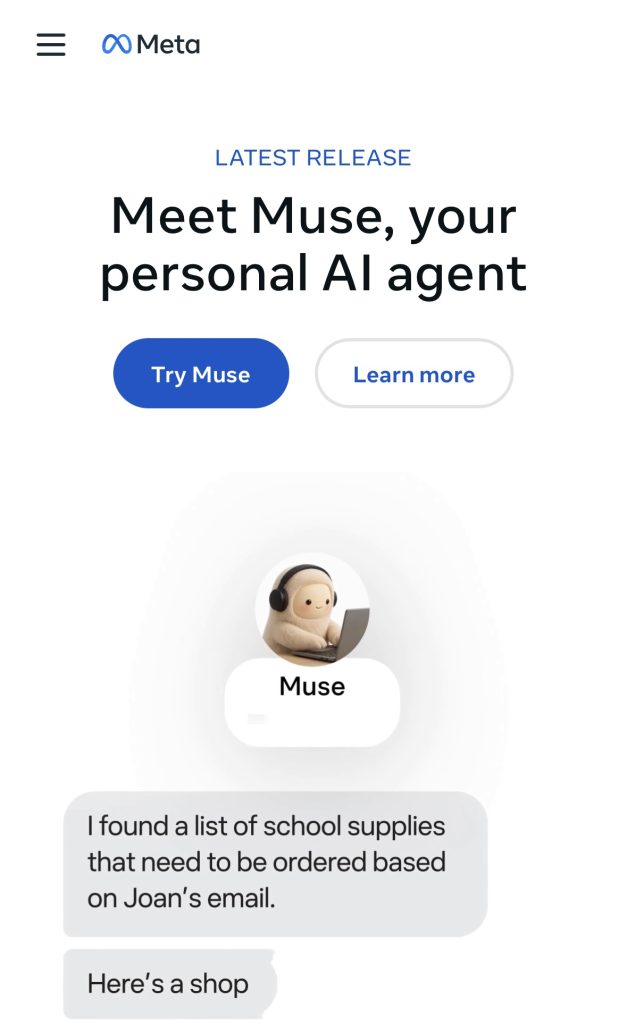
Muse AI 로고와 쇼핑 및 예산 관리 기능을 보여주는 인터페이스 이미지

AI 뮤즈(Muse)란? ChatGPT·Gemini·Claude·Grok과 무엇이 다르고 왜 뜨고 있을까

Muse(뮤즈)는 단순히 질문에 답하는 대화형 AI가 아니라, 사용자를 대신해 실제 업무를 수행하는 개인 AI 에이전트를 지향합니다. ChatGPT·Gemini·Claude·Grok이 글쓰기, 분석, 검색, 코딩 등 ‘질문에 답하고 콘텐츠를 만드는 AI’를 중심으로 발전해왔다면, Muse는 한 단계 더 나아가 웹과 연결된 서비스를 직접 활용해 여러 단계의 작업을 실행하고 완료하는 데 초점을 맞추고 있습니다.

Meta는 2026년 9월 8일 Muse를 공개하면서, 단순히 답변을 생성하는 챗봇이 아니라 이메일, 예약, 쇼핑, 일정, 문서 작업, 웹 탐색 같은 일을 사용자를 대신해 수행하는 개인 AI 에이전트라고 설명했습니다. 핵심은 “무엇을 물어보느냐”보다 “무엇을 맡기느냐”입니다.
Muse AI 로고와 쇼핑 및 예산 관리 기능을 보여주는 인터페이스 이미지

Muse를 한 문장으로 설명하면

ChatGPT가 ‘같이 생각해주는 AI’라면, Muse는 ‘일을 넘겨받아 처리하는 AI’에 더 가깝습니다.

예를 들어 “이번 주말 서울 근교에서 1박 2일 가족여행 계획 짜줘”라고 했을 때 일반적인 챗봇은 여행지, 숙소, 맛집을 추천하는 데 강합니다. Muse는 한 단계 더 나아가 숙소 후보를 조사하고, 일정표를 만들고, 연결된 서비스가 있다면 예약 단계까지 진행하고, 필요한 순간에 사용자 승인을 요청하는 흐름을 목표로 합니다.

왜 지금 Muse가 뜨고 있을까?

최근 AI 경쟁의 중심이 ‘어떤 모델이 더 똑똑한가’에서 ‘누가 실제로 더 많은 일을 대신해주는가’로 이동하고 있습니다. Muse가 주목받는 이유도 여기에 있습니다.

1. 답변형 AI에서 실행형 AI로

기존 생성형 AI의 기본 흐름은 질문 → 답변이었습니다. Muse는 목표 → 계획 → 실행 → 승인 → 완료라는 흐름을 지향합니다. 이 차이는 작아 보이지만 사용 경험은 완전히 달라집니다.

  • “이번 달 카드 사용 내역을 정리해줘” → 분석에서 끝나는 것이 아니라 예산표 업데이트까지
  • “출장 준비해줘” → 항공·숙소 후보 조사, 일정 정리, 예약 단계 진행
  • “거래처 미팅 잡아줘” → 이메일 작성, 일정 확인, 메시지 발송 준비
  • “온라인 쇼핑 도와줘” → 제품 비교, 가격 확인, 구매 직전 승인 요청

2. 개인 전용 컴퓨터처럼 동작하는 Muse Secure VM

Meta는 Muse가 Muse Secure VM이라는 전용 가상 환경에서 동작한다고 설명합니다. Muse는 이 환경 안에서 자체 브라우저를 사용하고, 연결된 서비스에서 여러 단계를 이어서 수행할 수 있습니다.
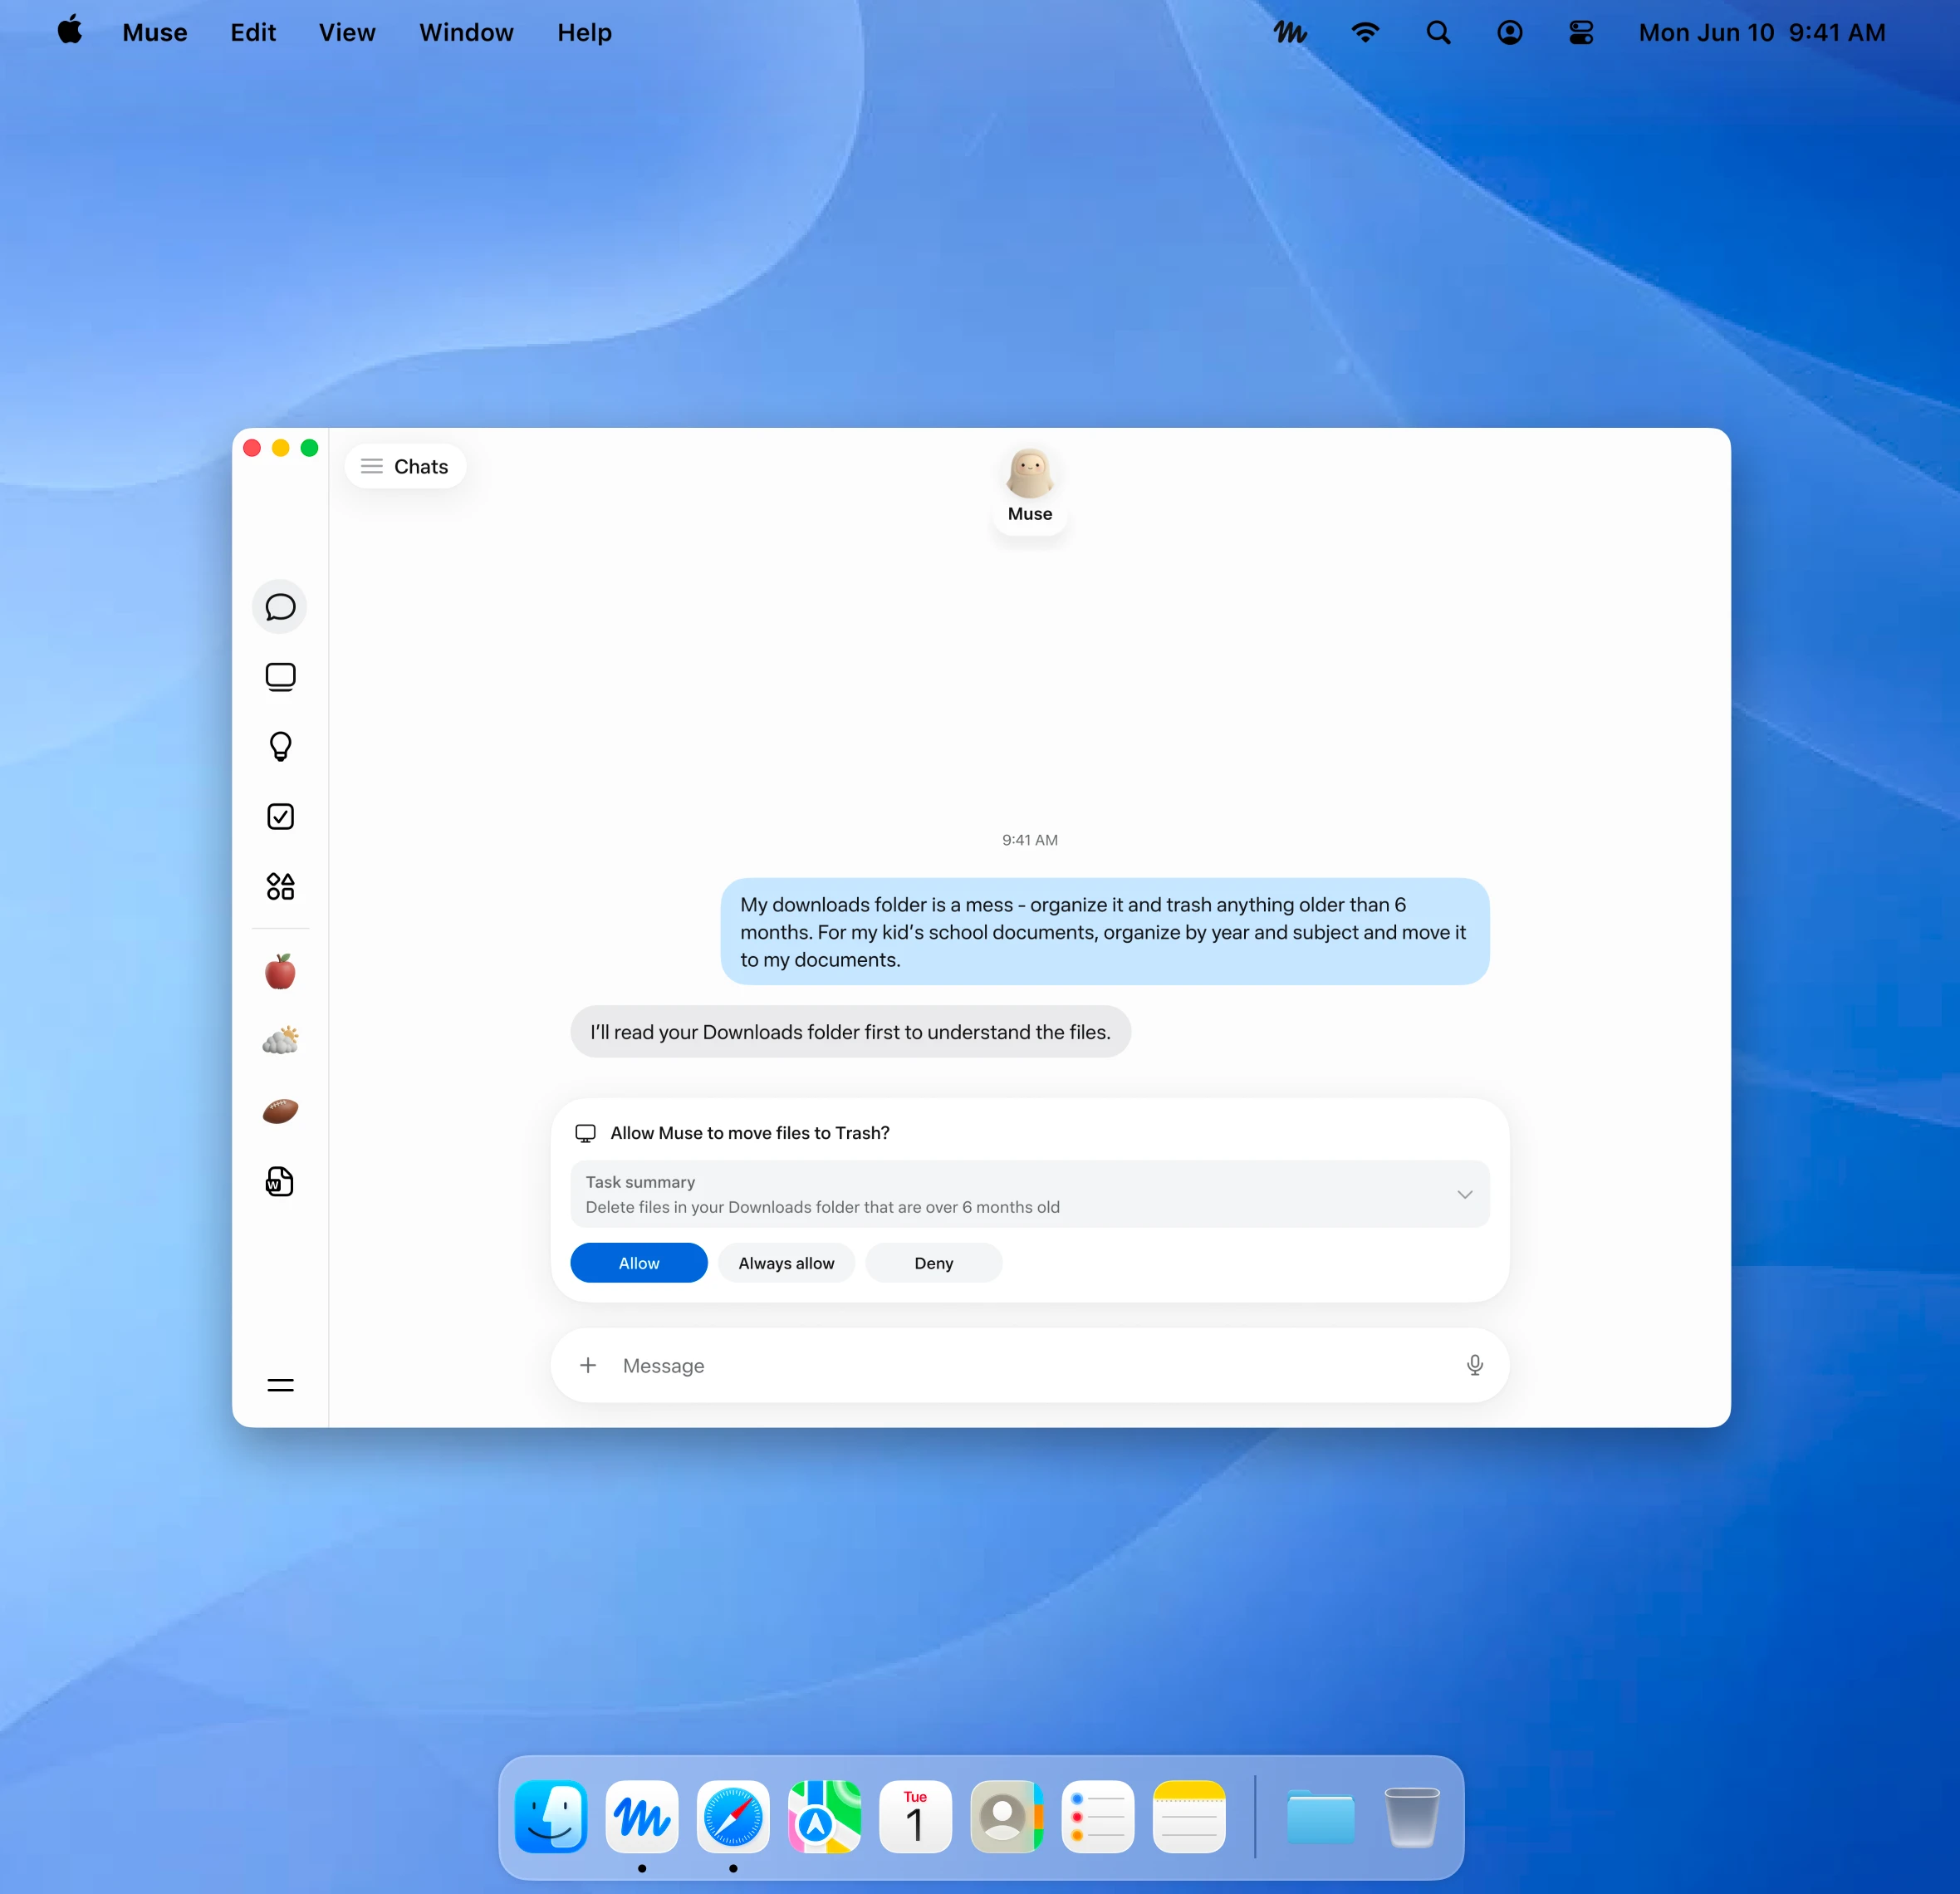
Muse AI가 macOS에서 파일 정리 작업을 요청하고 사용자 승인을 받는 화면

3. 앱을 닫아도 일을 이어가는 ‘지속형 에이전트’

Muse는 사용자가 앱을 계속 열어두지 않아도 백그라운드에서 작업을 이어가는 방향으로 설계됐습니다. 이것이 요즘 업계에서 말하는 persistent agent, 지속형 에이전트 개념입니다.

예를 들어 “이 항공권 가격이 내려가면 알려줘”, “이번 주 안에 최적의 후보 3개를 정리해줘”, “이 프로젝트 준비를 계속 진행해줘”처럼 한 번 지시하고 기다리는 방식이 가능해지는 것입니다.

4. WhatsApp과 Meta 생태계

Muse는 Muse 앱뿐 아니라 WhatsApp 안에서도 사용할 수 있도록 설계됐습니다. 사용자가 이미 익숙한 메신저에서 바로 개인 에이전트를 부를 수 있다는 점은 접근성에서 큰 장점입니다.

5. AI 글래스로 확장

Meta는 Connect 2026에서 Muse를 AI 글래스에 적용한다고 발표했습니다. 앞으로는 눈앞의 물건이나 전단지, 제품을 보고 “이거 사려면 어디가 싸?”라고 묻고, Muse가 실제 행동까지 이어가는 형태가 가능해질 수 있습니다.

Muse vs ChatGPT vs Gemini vs Claude vs Grok

AI 가장 강한 방향 잘하는 일 핵심 차이
Muse 개인 에이전트 예약, 쇼핑, 이메일, 일정, 웹 작업, 장기 업무 대화보다 ‘일을 맡아서 실행’하는 데 초점
ChatGPT 범용 AI 글쓰기, 코딩, 분석, 리서치, 이미지, 업무 전반 가장 넓은 활용 범위와 생태계
Gemini Google 생태계 Gmail, Drive, Calendar, 검색, 멀티모달 구글 서비스를 많이 쓰는 사용자에게 유리
Claude 문서·코딩·분석 긴 글, 문서 이해, 개발, 복잡한 사고 신중한 글쓰기와 긴 문맥 처리에 강점
Grok 실시간 정보·X 생태계 트렌드, 소셜 반응, 빠른 답변 X 기반 실시간 맥락과 강한 캐릭터성

ChatGPT와 비교하면?

ChatGPT의 강점은 범용성입니다. 글을 쓰고, 코드를 만들고, 이미지를 분석하고, 데이터를 정리하고, 다양한 앱과 연결해 복잡한 작업을 처리할 수 있습니다. 특히 전문 업무나 개발, 연구처럼 ‘생각의 품질’이 중요한 작업에서는 매우 강력합니다.

Muse가 더 강조하는 것은 위임입니다. 사용자와 계속 대화하며 하나씩 지시받기보다, 일정한 목표를 받아 여러 단계를 스스로 처리하는 구조가 더 중심에 있습니다.

쉽게 구분하면:
ChatGPT = 같이 일하는 AI 동료
Muse = 일을 맡길 수 있는 개인 비서형 에이전트

Gemini와 비교하면?

Gemini의 가장 큰 무기는 Google 생태계입니다. Gmail, Google Drive, Calendar, Docs, 검색과 자연스럽게 연결됩니다. 이미 업무 대부분을 Google 서비스에서 처리한다면 Gemini의 편의성은 상당합니다.

반면 Muse는 특정 생산성 앱 하나에 묶이기보다 다양한 웹 서비스와 일상 업무를 넘나드는 ‘개인 실행 에이전트’를 더 강하게 지향합니다.

Claude와 비교하면?

Claude는 긴 문서 분석, 글쓰기, 코딩, 복잡한 문제 정리에 강점을 보입니다. 특히 보고서나 기획서, 코드베이스처럼 많은 문맥을 차분하게 처리해야 할 때 강력합니다.

Muse는 ‘문서를 얼마나 잘 쓰느냐’보다 ‘그 문서를 이용해 다음 행동까지 얼마나 이어가느냐’에 더 초점을 맞춥니다.

Grok과 비교하면?

Grok의 강점은 X를 중심으로 한 실시간 정보와 빠른 사회적 맥락입니다. 지금 무슨 일이 벌어지고 있는지, 어떤 이슈가 뜨는지 확인하는 데 장점이 있습니다.

Muse는 실시간 트렌드 자체보다는 사용자의 실제 생활과 업무를 대신 처리하는 역할에 더 가깝습니다.

지금 Muse가 더 매력적인 이유: ‘토큰 걱정’ 없이 AI를 써보는 경험

Muse를 이야기할 때 기능만큼 중요한 것이 사용량에 대한 심리적 부담입니다. AI를 자주 사용하는 사람이라면 “이 작업을 계속 돌리면 사용량이 얼마나 나올까?”, “긴 문서를 넣어도 괜찮을까?”, “에이전트에게 여러 단계를 맡기면 금방 한도에 도달하지 않을까?”라는 생각을 한 번쯤 하게 됩니다.

특히 고성능 모델은 계산 자원이 많이 필요합니다. API 기준으로 보면 최신 상위 모델의 토큰 가격은 결코 무시하기 어렵습니다. 2026년 10월 기준 GPT-6 Astra는 표준 API에서 100만 입력 토큰당 약 10달러, 출력 토큰당 약 50달러 수준이며, GPT-5.6 Sol은 입력 4달러·출력 20달러 수준입니다. Anthropic의 Claude Opus 5.5 역시 입력 4달러·출력 20달러 수준입니다.

모델/서비스 100만 입력 토큰 100만 출력 토큰 사용자 관점
GPT-6 Astra 약 $10 약 $50 최상위 성능, 대규모 사용 시 비용 고려 필요
GPT-5.6 Sol 약 $4 약 $20 고성능 전문 작업에 적합
Claude Opus 5.5 약 $4 약 $20 복잡한 코딩·에이전트·전문 작업에 강점
Muse 소비자용 무료 사용 구간 제공 처음 AI 에이전트를 경험하기 좋은 낮은 진입장벽

※ 위 가격은 각 회사의 API 기준으로, 소비자용 ChatGPT·Claude·Muse 구독 서비스의 사용량과 직접 비교할 수 있는 숫자는 아닙니다. Muse 내부의 토큰 단위 역시 다른 회사 API 토큰과 1:1 가치로 환산해서는 안 됩니다.

중요한 것은 ‘얼마짜리 토큰인가’보다 마음 편하게 써볼 수 있다는 것

여기서 Muse의 전략이 재미있습니다. Meta 공식 안내에 따르면 Muse는 현재 사용량 제한이 있는 무료 구간을 제공합니다. 무료 한도에 도달하면 한도가 갱신될 때까지 기다리거나 유료 플랜으로 업그레이드할 수 있습니다.

이 차이는 생각보다 큽니다. AI를 처음 접하는 사람에게 가장 좋은 학습 방법은 설명서를 읽는 것이 아니라 직접 이것저것 시켜보는 것이기 때문입니다.

“이거 시켜도 되나?”가 아니라 “이것도 한번 시켜볼까?”
무료 사용량이 주는 가장 큰 혜택은 바로 이 심리적 변화일 수 있습니다.

여행 계획을 한번 맡겨보고, 이메일을 정리하게 하고, 가격을 추적하게 하고, 문서를 만들어보는 식으로 시행착오를 반복하다 보면 사용자는 자연스럽게 “AI 에이전트에게 어떤 일을 맡길 수 있는지”를 익히게 됩니다.

10억 토큰 프로모션이 크게 느껴지는 이유

현재 일부 신규 가입·추천 과정에서는 대규모 Muse 토큰이 지급되는 프로모션이 사용자 사이에서 특히 주목받고 있습니다. 이 숫자가 눈에 띄는 이유는 단순히 숫자가 크기 때문만은 아닙니다. 사용자가 초기부터 사용량을 지나치게 아끼지 않고 여러 기능을 시험해볼 수 있다는 인상을 주기 때문입니다.

다만 여기에는 꼭 주의할 점이 있습니다. Muse의 10억 토큰을 GPT-6 Astra나 Claude Opus의 API 토큰 10억 개와 동일하게 계산해 금액으로 환산하면 안 됩니다. 서비스마다 토큰 계산 방식, 모델, 에이전트 실행 비용, 도구 사용량이 다르기 때문입니다. 따라서 “수천 달러 상당”처럼 단순 환산하기보다는 초기 사용자가 사용량 부담 없이 Muse를 경험하도록 만드는 공격적인 체험 전략으로 이해하는 편이 정확합니다.

무료 전략은 단순한 선물이 아니라 사용자 확보 전략이다

에이전트형 AI는 일반 챗봇보다 사용자가 익혀야 할 것이 많습니다. 이메일과 캘린더를 연결하고, 브라우저 작업을 맡기고, 구매 전 승인 방식을 익혀야 합니다. Meta 입장에서는 사람들이 Muse를 충분히 사용해봐야 이런 새로운 사용 습관이 만들어집니다.

따라서 무료 사용 구간은 단순한 가격 할인보다 더 전략적인 의미가 있습니다. “AI에게 질문하는 습관”에서 “AI에게 일을 맡기는 습관”으로 사용자를 이동시키는 것입니다.

실제로 Muse는 무료 구간을 제공하면서 더 많은 사용량이 필요한 사용자를 위한 유료 플랜도 운영하고 있습니다. 결국 무료로 넓은 사용자를 끌어들이고, AI 에이전트가 생활과 업무에 자리 잡은 헤비유저를 유료 서비스로 연결하는 구조라고 볼 수 있습니다.

그래서 Muse의 ‘무료’가 강력하다

ChatGPT, Claude, Gemini 같은 서비스가 AI의 성능 경쟁을 빠르게 끌어올렸다면 Muse는 여기에 실행 능력 + 낮은 진입장벽이라는 카드를 던졌습니다.

최고 성능의 모델이 항상 가장 많은 사람에게 선택되는 것은 아닙니다. 충분히 좋은 성능을 갖추고 있으면서, 사용자가 가격이나 토큰을 계속 계산하지 않고 마음 편하게 여러 일을 맡겨볼 수 있다면 그것 자체가 매우 강력한 경쟁력이 됩니다.

Muse의 현재 무료 전략이 중요한 이유는 ‘공짜 AI’이기 때문이 아니라, AI 에이전트라는 새로운 사용법을 사람들이 부담 없이 학습하게 만들고 있기 때문입니다.

Muse의 진짜 장점은 ‘모델 성능’보다 구조에 있다

Muse를 이해할 때 가장 중요한 포인트입니다. Muse가 뜨는 이유는 단순히 “Meta의 새 모델이 ChatGPT보다 똑똑하다”는 식의 이야기가 아닙니다.

핵심은 AI + 전용 브라우저 + 장기 메모리 + 연결 서비스 + 권한 관리 + 백그라운드 실행이 하나의 제품으로 묶였다는 점입니다.

AI 경쟁의 다음 라운드는 “누가 더 좋은 답을 쓰는가?”보다 “누가 실제로 일을 끝내주는가?”에 가까워지고 있습니다.

실제 활용 예시 1: 여행 계획

일반 챗봇에 요청: “후쿠오카 2박 3일 여행 코스 추천해줘.”

결과: 추천 관광지, 맛집, 이동 동선, 예상 비용을 알려줍니다.
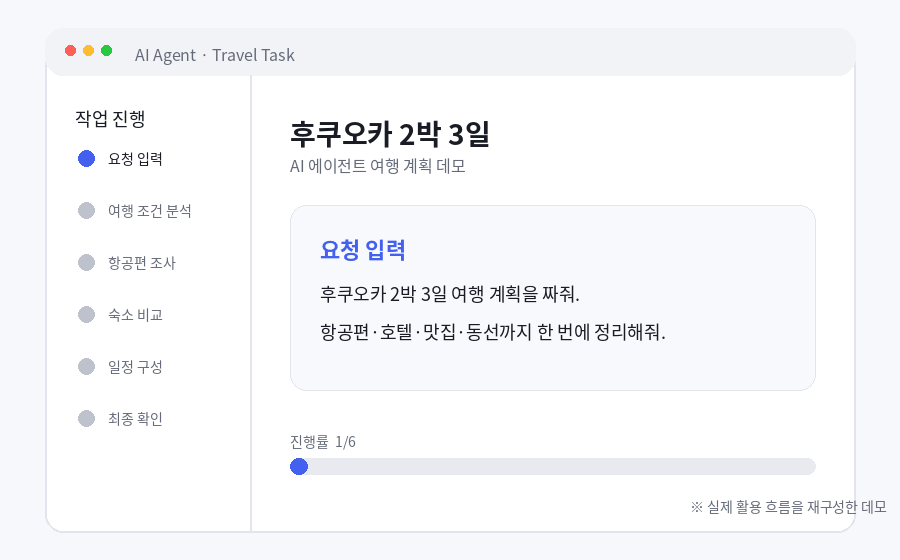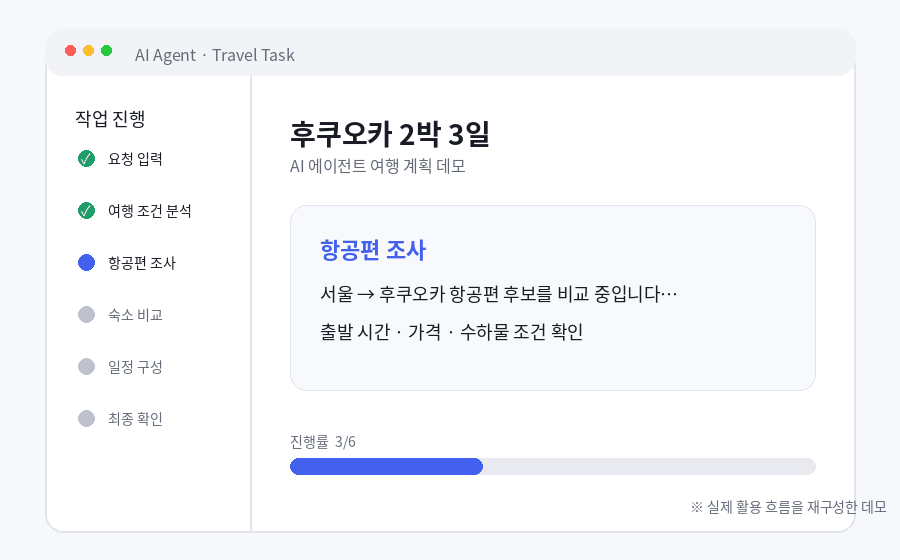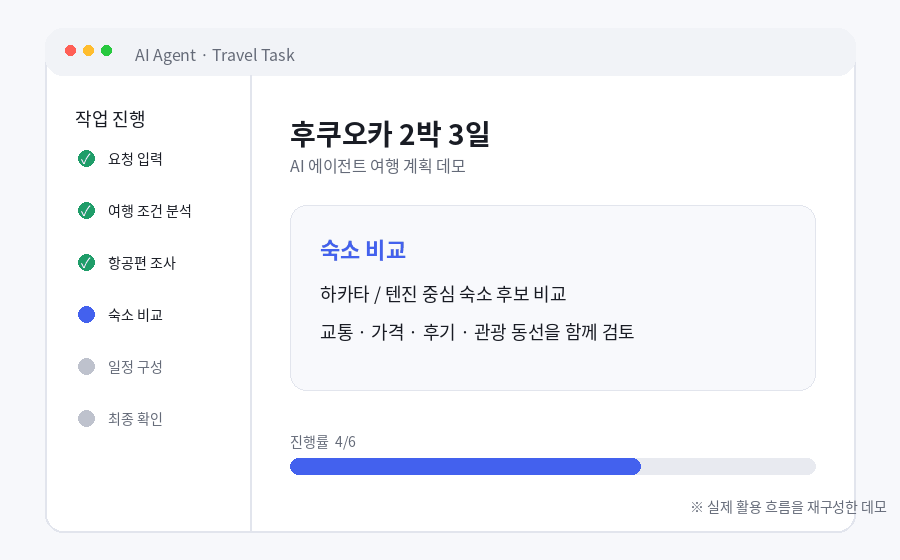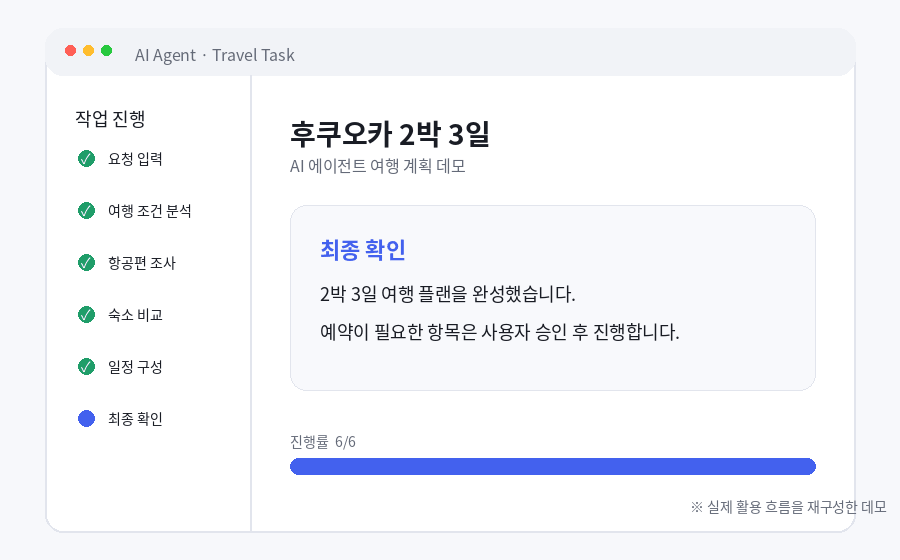
Muse식 요청: “후쿠오카 2박 3일 여행을 준비해줘. 항공편과 숙소 후보를 비교하고, 맛집과 관광지를 이동 동선에 맞춰 정리해줘. 예약이 필요한 항목은 마지막에 확인받아줘.”

  1. 조건에 맞는 항공편 탐색
  2. 숙소 후보 비교
  3. 렌터카 확인
  4. 이동 동선 정리
  5. 전체 예산 계산
  6. 예약 전 사용자 승인
  7. 확정 일정 정리

실제 활용 예시 2: 이메일과 일정

Gmail 받은편지함 메일 목록 화면 예시

“다음 주 거래처 김 팀장님과 30분 미팅을 잡아줘. 수요일 오후는 제외하고, 가능한 시간 3개를 찾아서 메일 초안도 만들어줘.”

전통적인 챗봇은 메일 초안을 만들어주는 데서 끝나는 경우가 많지만, 개인 에이전트는 캘린더를 확인하고 가능한 시간을 찾은 뒤 메일 발송 단계까지 연결하는 것이 목표입니다.

실제 활용 예시 3: 쇼핑
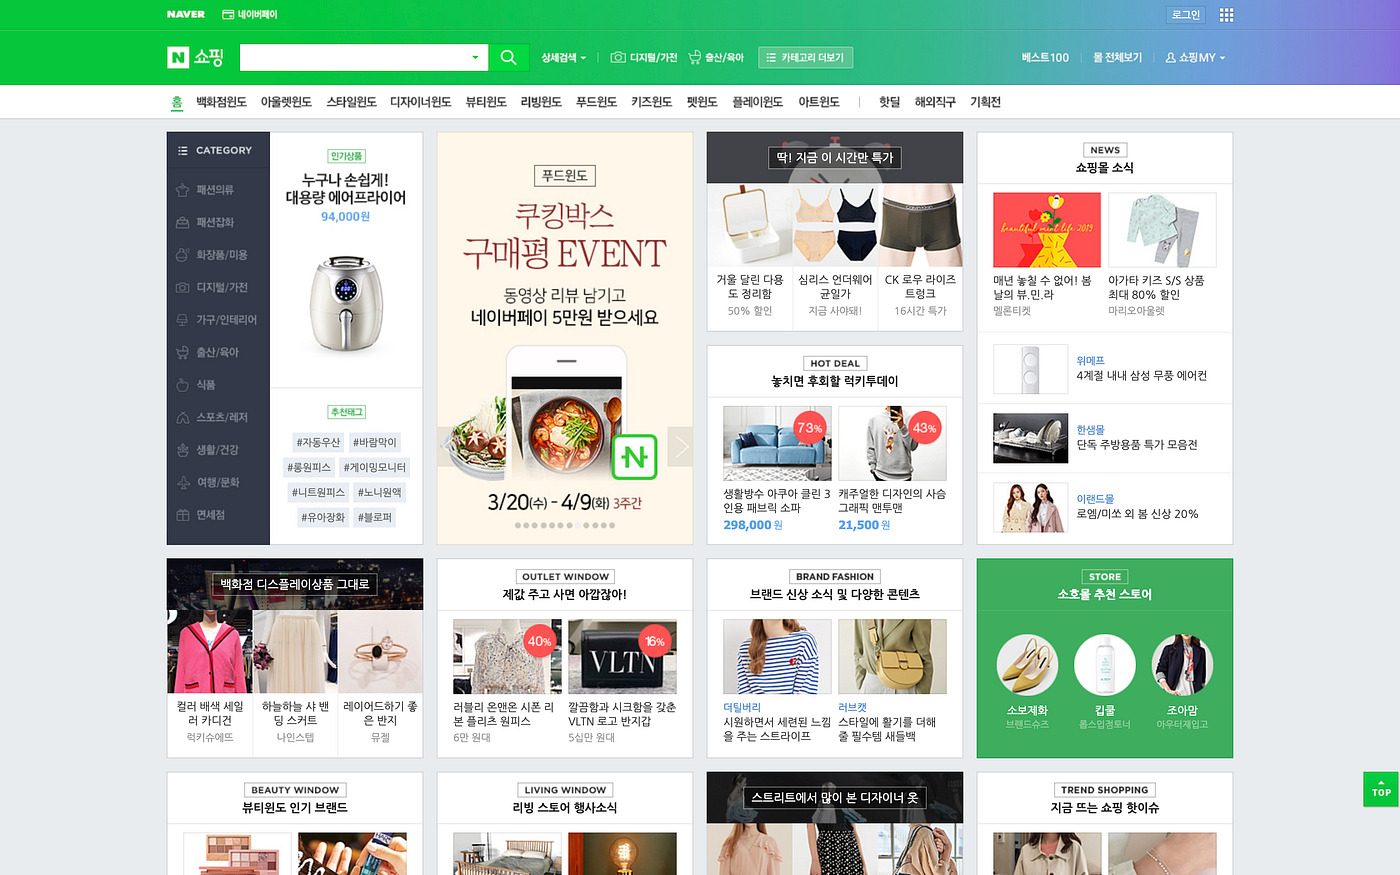
네이버 쇼핑 메인 페이지 화면 예시

“RTX 5090 그래픽카드를 사고 싶은데, 너무 비싼 프리미엄 모델은 제외하고 국내외 가격을 비교해서 가장 합리적인 후보 3개만 골라줘. 가격이 내려가면 다시 알려줘.”

이런 작업은 단발성 검색보다 ‘계속 지켜보고 판단하는 AI’가 더 잘 어울립니다. Muse가 노리는 영역도 바로 이런 장기형 작업입니다.

그렇다면 Muse가 모든 면에서 더 좋은가?

그렇지는 않습니다. Muse는 이제 막 출시된 제품이고, 지역별 제공 범위와 연결 가능한 서비스에 제한이 있습니다. 또한 에이전트가 실제 계정과 결제, 이메일, 예약 등에 접근할수록 권한과 개인정보 관리가 더 중요해집니다.

Meta는 민감한 작업 전 사용자 승인을 요구하고, 별도의 Sentinel 시스템으로 행동을 점검하며, 연결 서비스별 권한을 사용자가 통제할 수 있도록 설계했다고 설명합니다. 하지만 AI가 실제로 행동하는 시대에는 “똑똑한가”만큼 “어디까지 맡길 것인가”가 중요해집니다.

그럼 어떤 AI를 써야 할까?

  • 글쓰기·코딩·분석·연구를 폭넓게 하고 싶다 → ChatGPT
  • Gmail·Drive·Calendar 중심으로 생활한다 → Gemini
  • 긴 문서, 글쓰기, 코드 분석이 중요하다 → Claude
  • 실시간 트렌드와 X 정보가 중요하다 → Grok
  • AI에게 실제 생활과 업무를 ‘맡기고’ 싶다 → Muse

앞으로는 하나만 쓰기보다 용도별로 두세 개를 함께 쓰는 방식이 자연스러워질 가능성이 큽니다.

참고할 만한 영상

AI 모델별 강점을 한 번에 비교하고 싶다면 아래 영상이 도움이 됩니다.

Meta의 Muse 공식 소개 자료도 함께 보면 ‘챗봇’과 ‘개인 에이전트’의 차이를 이해하기 쉽습니다.

Meta 공식 Muse 소개 보기

Muse를 직접 사용해보고 싶다면

Muse의 특징을 이해했다면 다음 단계는 실제 가입입니다. 국내에서 접속이 원활하지 않을 때를 포함해 아이폰·안드로이드에서 진행하는 과정을 별도 글로 정리했습니다.

▶ AI 뮤즈 가입 방법|아이폰·안드로이드 가입 가이드

정리

Muse가 주목받는 이유는 단순히 또 하나의 AI 챗봇이 나왔기 때문이 아닙니다. AI의 역할이 ‘답변’에서 ‘실행’으로 이동하고 있다는 신호이기 때문입니다.

지금까지는 사람이 AI에게 질문하고 결과를 복사해 다른 앱에 붙여 넣었다면, 앞으로는 AI가 앱과 웹을 직접 넘나들며 일을 끝내고 사람은 중요한 순간에 승인만 하는 방식이 점점 늘어날 가능성이 큽니다.

Muse는 그 변화를 가장 대중적인 형태로 보여주려는 제품 중 하나입니다.


※ Muse의 기능과 제공 국가, 요금제, 연결 서비스는 빠르게 변경될 수 있습니다. 본 글은 2026년 10월 기준 공개된 Meta 자료와 관련 보도를 바탕으로 정리했습니다.
AI 뮤즈 가입 방법|VPN 없이 안 될 때, 아이폰·안드로이드 에서 가입방법

Browserling 방식으로 진행이 어렵다면, Turbo VPN(터보 VPN)을 통하여 가입할 수 있습니다. 기존 어떤 VPN이라도 상관 없습니다. 기존 사용하고 계신 VPN 이 있다면 바로 5번 단계로 이동 하시면 됩니다.

기존 글에 첨부한 뮤즈 화면
Muse, 메인화면 안내

아이폰은 App Store, 갤럭시 등 안드로이드 휴대폰은 Google Play에서 앱을 설치합니다. 이메일 인증에 사용할 메일함도 준비해주세요.

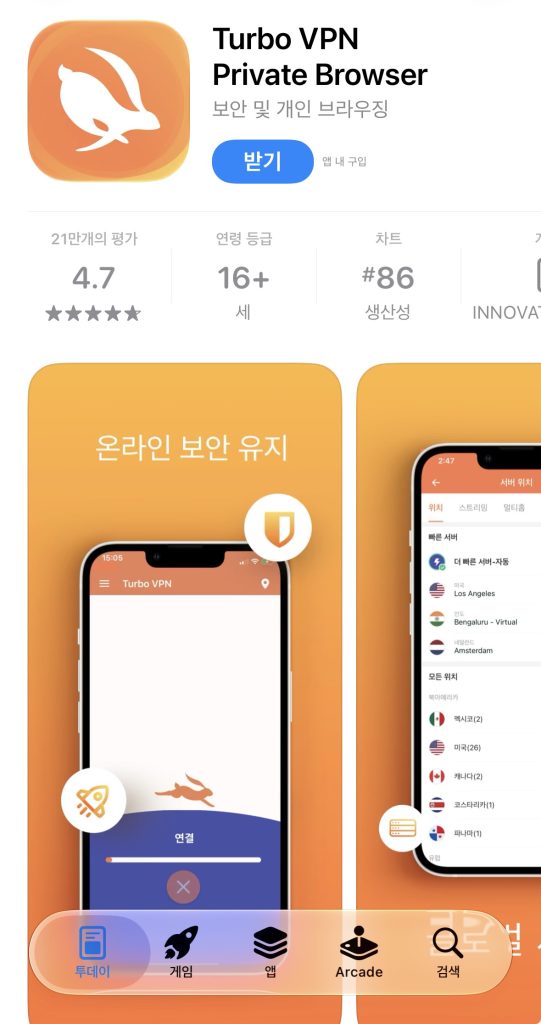
Turbo VPN
Turbo VPN

앱스토어 에서는 Turbo VPN Private Browser, 안드로이드는 Turbo VPN – Secure VPN Proxy입니다.

▶ 아이폰 App Store에서 Turbo VPN 열기
▶ 안드로이드 Google Play에서 Turbo VPN 열기

Turbo VPN 설치하시고. 무료로 진행하려면 구독 체험 화면을 누르지 마시고 좌측 상단에 X 표시를 누르면 됩니다.

1. 프로파일 설치 및 VPN 접속 확인 (미국)

iOS가 VPN 구성 추가를 요청하면 내용을 확인하고 허용을 누릅니다. 기기 암호가 요구되면 입력합니다.

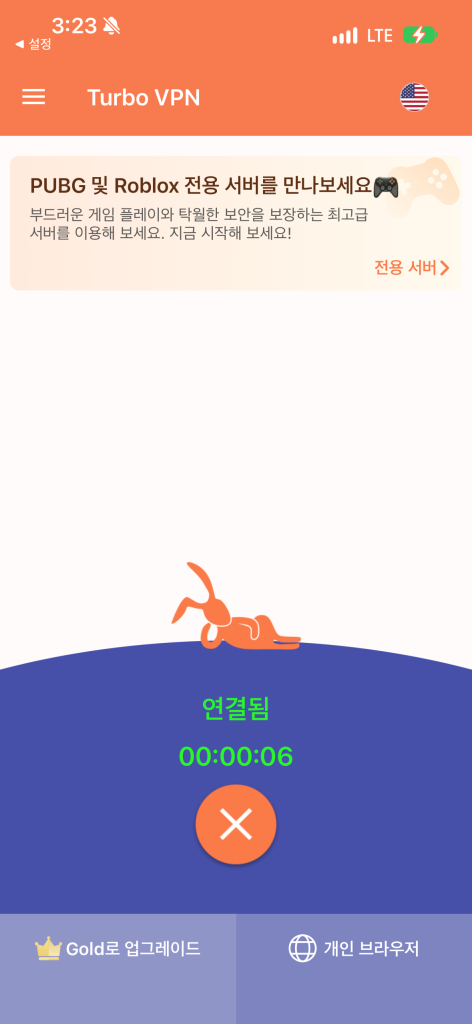
  1. 앱으로 돌아와 연결 상태를 확인합니다. Connecting은 연결 중이라는 뜻이므로 연결 완료 표시가 나올 때까지 기다립니다. 연결이 완료되면 다음과 같은 화면이 나옵니다.
Turbo VPN
Turbo VPN, 접속 성공화면

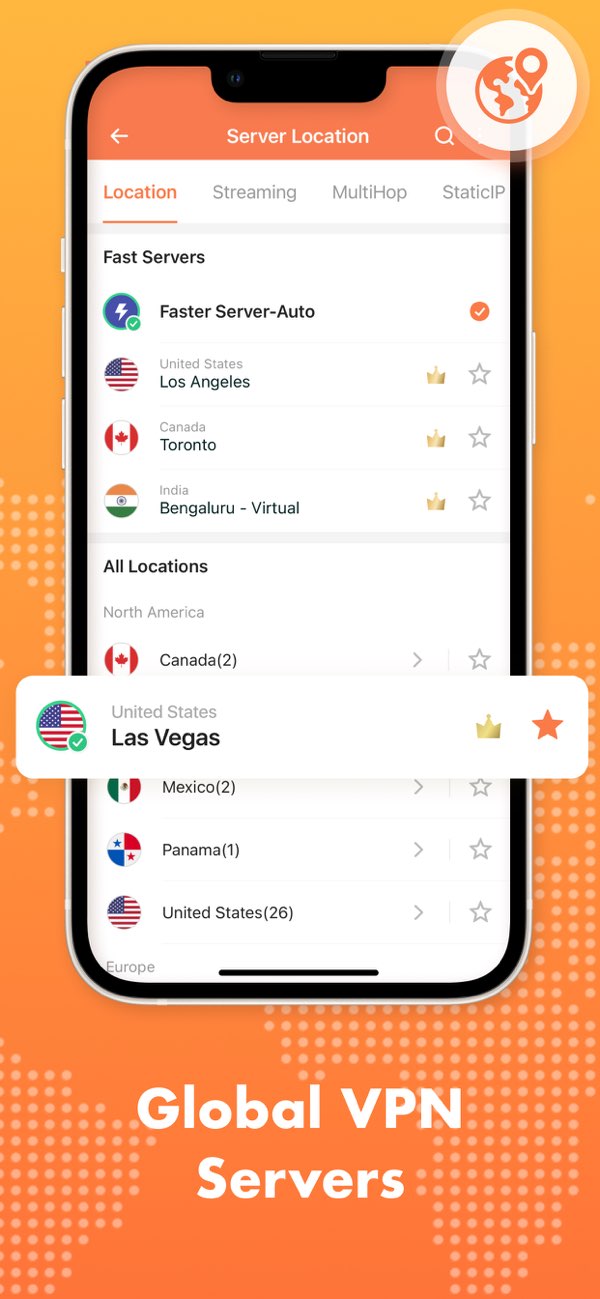
2. 처음 접속시 서버 국가 선택하는 방법(미국 연결이 안된다면)

자동 연결이 보통 미국으로 선택이 되는데요 혹시라도 미국으로 안되있다면 United States 항목을 찾아 연결합니다.

Turbo VPN의 United States 등 국가별 서버 선택 화면

4. 안드로이드에서 Turbo VPN 다운로드·설치하기

  1. 갤럭시 등 안드로이드 휴대폰에서 Google Play 스토어를 열고 Turbo VPN을 검색합니다. 또는 위의 안드로이드 다운로드 링크를 누릅니다.
  2. Turbo VPN – Secure VPN Proxy, 개발사 Innovative Connecting을 확인하고 설치를 누릅니다.
  3. 설치가 끝나면 열기를 누르고 초기 안내를 확인합니다. 광고나 유료 상품 안내가 표시될 수 있습니다. 무료로 이용하려면 무료 이용 항목을 확인합니다.
  4. 앱의 연결 버튼을 누릅니다. 공식 스토어 화면에는 TAP TO CONNECT로 표시되어 있지만 버전·언어에 따라 문구가 달라질 수 있습니다.
  5. 안드로이드의 VPN 연결 요청 창이 나타나면 내용을 확인하고 확인 또는 시스템이 제공하는 허용 버튼을 누릅니다.
  6. 서버 목록에서 필요한 국가를 선택할 수 있는지 확인합니다. 미국 서버가 필요하다면 United States를 찾되, 유료 표시가 있는지 먼저 확인합니다.
  7. 앱에서 연결 완료를 확인한 뒤 Chrome을 열어 뮤즈 접속을 진행합니다. 상태 표시줄의 VPN·열쇠 아이콘은 기종에 따라 표시 방식이 다릅니다.

5. VPN 연결 후 뮤즈 가입 화면 확인하기

  1. Safari 또는 Chrome 주소창에 https://ai.meta.com/을 입력합니다. 공식 페이지에서 제공하는 Muse 시작·가입 링크를 따라갑니다.
  2. 가입 화면이 열리면 해당 화면에서 제공하는 신규 이메일로 안전하게 생성이 가능하오니 계정 생성을 통하여 진행합니다.
  3. 이메일 인증을 요구하면 본인이 사용할 수 있는 이메일을 입력하고, 메일함으로 도착한 인증 코드나 링크로 인증합니다.
  4. 추가 인증이 표시되면 화면에 나온 조건을 읽고 진행합니다.
  5. 가입 후 실제 서비스 화면까지 열리고, 기본적으로 상호간에 이름을 지정하면 바로 Muse 앱 사용이 가능합니다.
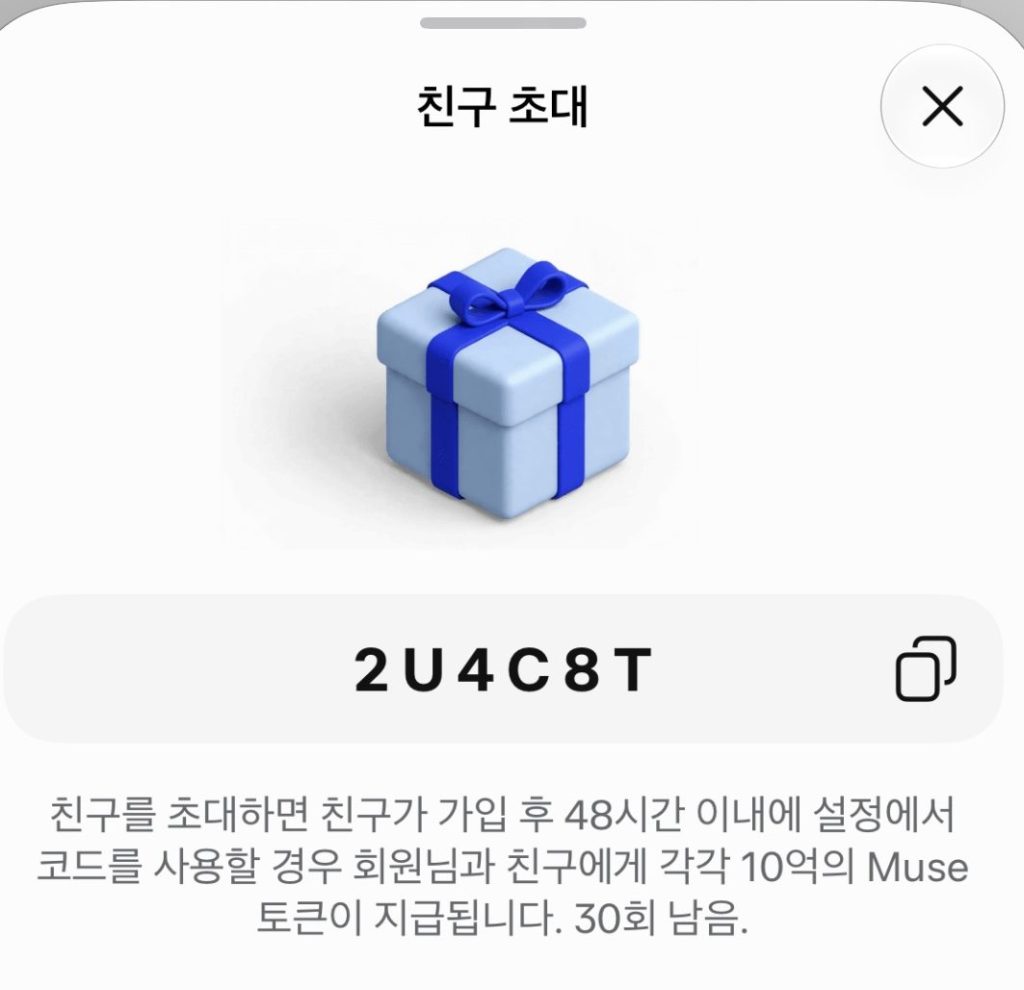
  6. 제일 중요! Muse 앱을 실행하고, 좌측하단 ‘설정’ 아이콘을 클릭하고 ‘추천 코드 사용’ 화면에서 추천인 코드: 2U4C8T 를 입력하고 계정에 토큰에 10억 충전 되었다고 나오면 끝입니다.

6. 추천인 코드 입력 안내

추천인 코드: 2U4C8T

기존 글에 첨부한 뮤즈 추천인 안내 화면

참고 링크

Turbo VPN 공식 아이폰 다운로드 안내
Turbo VPN 공식 안드로이드 다운로드 안내
App Store 앱 정보
Google Play 앱 정보
Turbo VPN 공식 지원: 연결했지만 특정 사이트가 열리지 않을 때

뮤즈가 정확히 어떤 AI인지 궁금하다면? 가입 후 무엇을 할 수 있는지, ChatGPT·Gemini·Claude·Grok과 어떤 차이가 있는지 아래 비교 글에서 자세히 확인할 수 있습니다.

▶ AI 뮤즈(Muse)란? ChatGPT·Gemini·Claude·Grok과 무엇이 다르고 왜 뜨고 있을까

Mac mini M6 출시, M4 비교, 성능과 달라진 점

2026년 9월 22일, Apple이 드디어 새로운 Mac mini M6를 정식 출시했습니다.

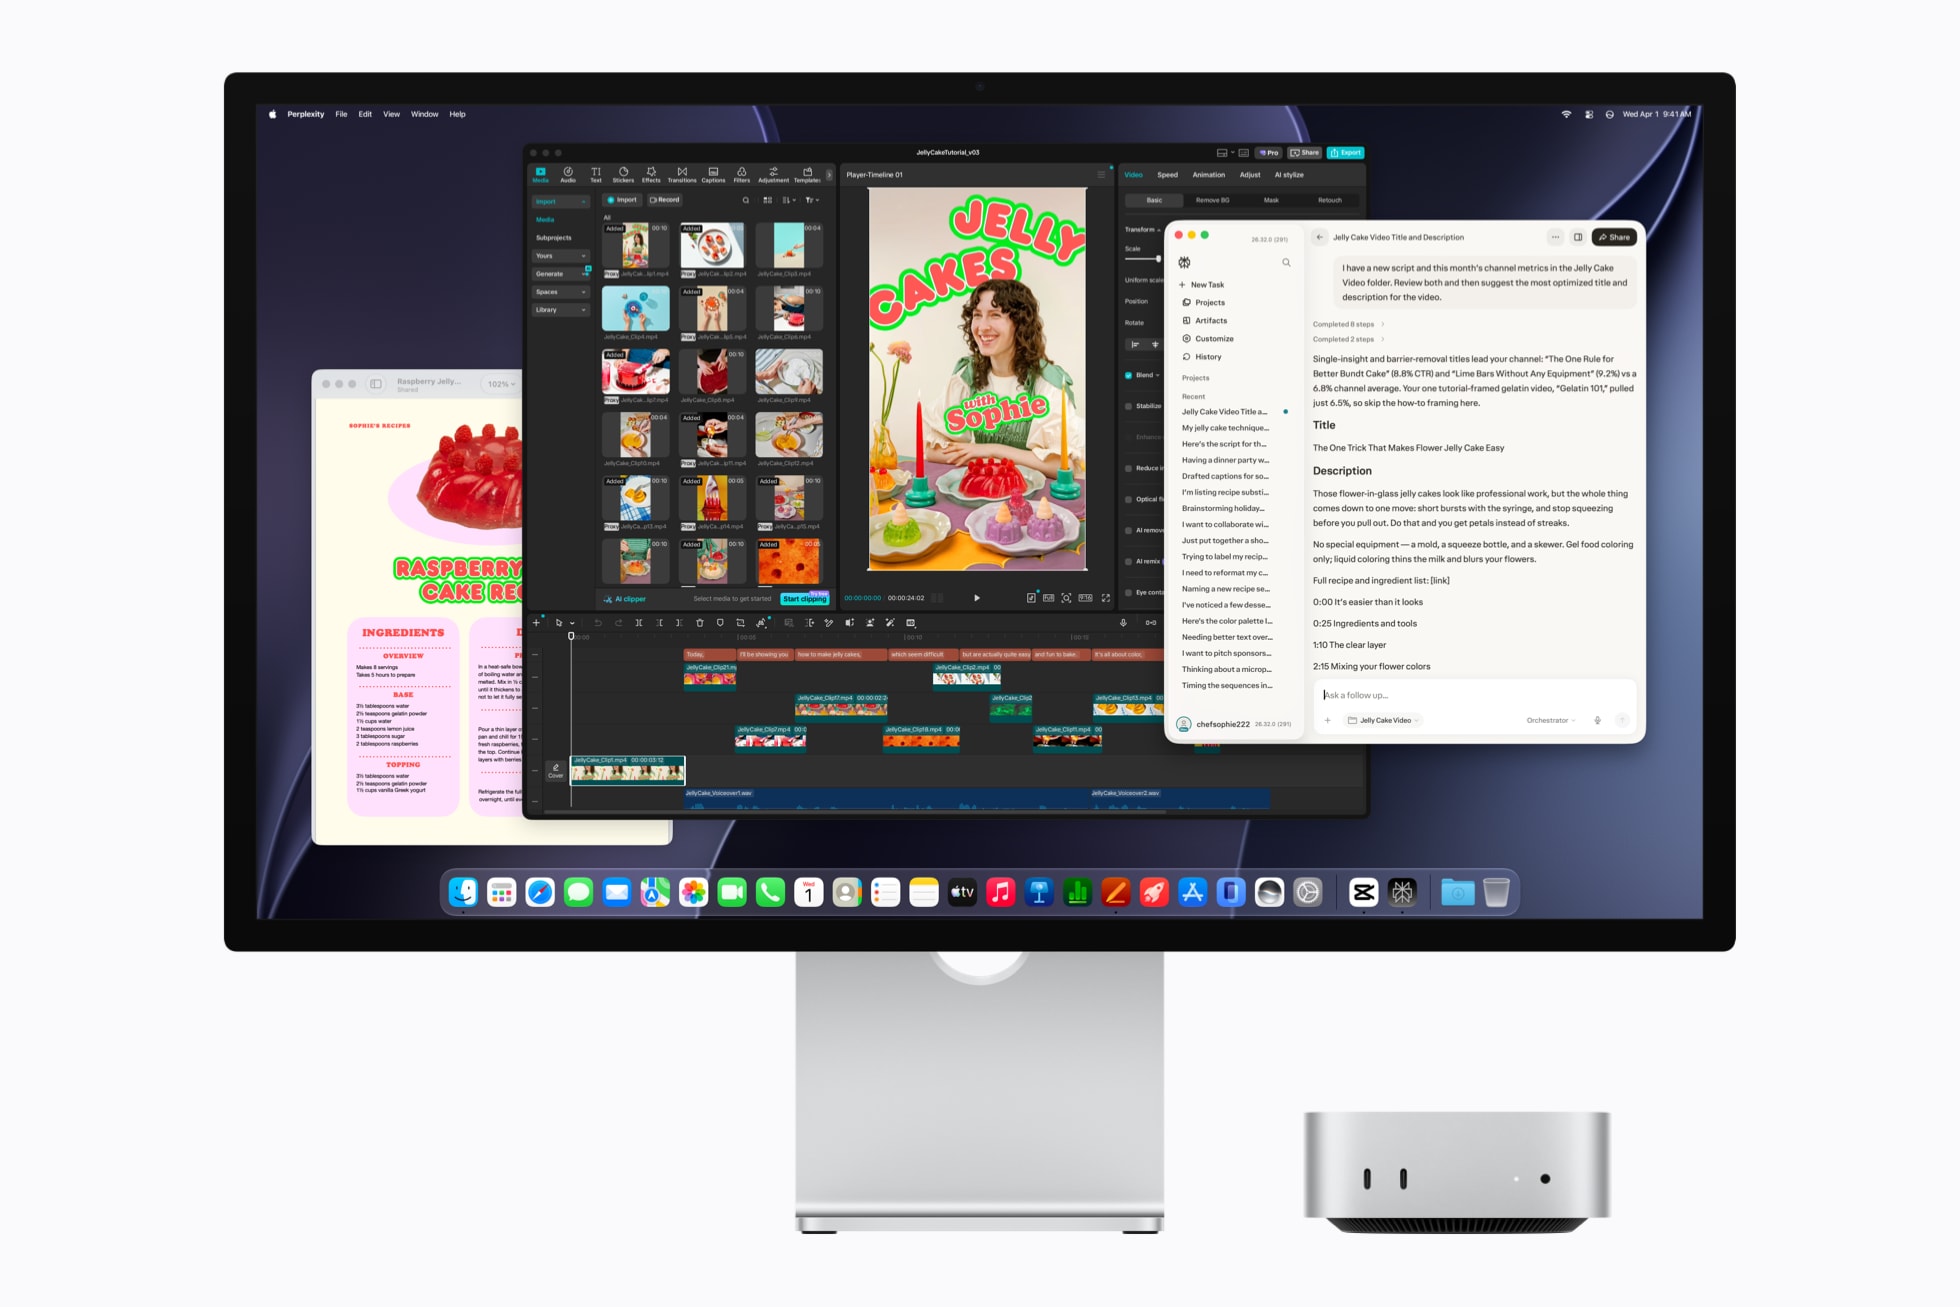
Mac mini는 원래도 작은 크기에 비해 성능이 뛰어난 데스크탑이었지만, 이번 M6 세대는 방향이 조금 다릅니다. 단순히 CPU와 GPU가 빨라진 것이 아니라, Apple이 대놓고 “AI 워크플로를 항상 켜두는 데스크탑”을 이야기하기 시작했습니다.

Apple Mac mini M6와 AI 작업 화면
Apple이 공개한 Mac mini M6의 AI·크리에이티브 워크플로 예시. 작은 본체지만 방향은 확실히 AI 쪽으로 기울었습니다.

Mac mini M6, 한국 출시 가격은 얼마일까?

Apple Korea 공식 발표 기준으로 M6 탑재 Mac mini의 시작 가격은 1,499,000원, 교육용 가격은 1,329,000원입니다.

상위 모델인 M5 Pro 탑재 Mac mini는 2,990,000원부터 시작합니다.

Apple 공식 판매 구성 중 24GB 메모리·512GB SSD 모델은 현재 2,179,000원으로 판매 됩니다.

모델한국 시작 가격메모리
Mac mini M61,499,000원16GB 기본, 최대 32GB
Mac mini M5 Pro2,990,000원최대 64GB

Apple 공식: 새로운 Mac mini와 Mac Studio, 오늘 정식 출시

그런데 M4는 89만원부터였는데?

맞습니다. 2024년 M4 Mac mini의 한국 출시 가격은 16GB 기준 890,000원부터였습니다.

M6의 시작 가격인 1,499,000원과 비교하면, 전 세계 AI 시장의 급성장으로 인한 메모리 수요 증가와 공급 부족이 맞물리면서 이번 세대의 시작 가격은 큰 폭으로 상승했습니다. 그래서 이번 세대는 단순히 “신형이니까 무조건 교체”라기보다는, AI·로컬 LLM·개발·영상 작업처럼 성능 차이를 실제로 쓰는 사람에게 의미가 더 큰 제품에 가깝습니다.

M4와 M6, 핵심 사양만 비교해보면

항목M4 Mac miniM6 Mac mini
CPU10코어12코어
GPU10코어12코어 + Neural Accelerators
Neural Engine16코어듀얼 16코어 Neural Engine
통합 메모리16/24/32GB16/24/32GB
메모리 대역폭120GB/s최대 170GB/s
무선Wi‑Fi 6E, Bluetooth 5.3Wi‑Fi 7, Bluetooth 6
이더넷1Gb 기본2.5Gb 기본, 10Gb 옵션

Apple의 공식 수치로는 M6 Mac mini가 M4 대비 CPU 최대 40% 향상, 그래픽 최대 2배, AI 성능 최대 4배 향상을 제시합니다.

또한 LM Studio에서의 LLM prompt processing은 Apple 테스트 기준으로 M4보다 최대 4.8배 빠르다고 설명합니다.

AI 성능이 정말 4배 일까? 

Apple의 “최대 4배 AI 성능”은 특정 워크로드와 테스트 조건에서 나온 수치입니다. 모든 로컬 LLM이 정확히 4배 빨라진다는 의미는 아닙니다.

특히 Ollama, LM Studio, llama.cpp 같은 로컬 LLM 도구는 대체로 GPU와 메모리 대역폭의 영향을 크게 받습니다.

그래도 M6에서 GPU 코어마다 Neural Accelerator를 넣고, 메모리 대역폭을 M4의 120GB/s에서 최대 170GB/s까지 올린 것은 로컬 AI 입장에서 꽤 의미가 큽니다.

LM Studio에서 로컬 LLM을 실행하는 화면
LM Studio는 Apple Silicon에서 로컬 LLM을 실행하기 쉬운 대표적인 도구입니다.

2nm M6, 뭐가 달라졌을까?

M6는 Apple의 첫 2 나노 칩입니다. 12코어 CPU와 12코어 GPU, GPU 코어별 Neural Accelerator, 듀얼 16코어 Neural Engine을 탑재했습니다.

작은 데스크탑 안에서 CPU·GPU·AI 연산을 동시에 끌어올리면서도 Apple Silicon 특유의 전력 효율을 유지하는 것이 핵심입니다.

게임 성능도 꽤 많이 올랐습니다

Apple은 Cyberpunk 2077 Ultimate Edition의 레이트레이싱 게임 성능에서 M4 대비 최대 2배를 제시합니다.

독립 리뷰에서도 M6 Mac mini가 1080p 게임에서 이전 세대보다 훨씬 여유로운 모습을 보인다는 평가가 나오고 있습니다.

다만 Mac mini를 게임 머신 하나만 보고 사는 것은 여전히 애매합니다. 이번 제품의 진짜 매력은 게임보다 개발 + 영상 + AI + 일반 작업을 한 박스에서 조용히 처리한다는 점입니다.

디자인은 거의 그대로입니다

외형은 2024년 M4 Mac mini에서 등장한 12.7cm 정사각형 디자인을 유지합니다. 즉 “새 Mac” 티는 거의 안 납니다. 책상 위에서 보면 예전 M4와 구분하기 어려울 정도입니다. 대신 기존 M4 Mac mini용 스탠드나 액세서리를 계속 활용하기 쉬운 장점이 있습니다.

연결성은 꽤 좋아졌습니다

M6 Mac mini는 Wi‑Fi 7, Bluetooth 6, 2.5Gb Ethernet을 기본 지원하고 10Gb Ethernet 옵션을 제공합니다.

NAS, 대용량 영상 파일, 로컬 AI 모델 파일을 자주 옮기는 사람이라면 2.5Gb Ethernet 기본 지원은 생각보다 반가운 변화입니다.

그럼 누가 M6 Mac mini를 사면 좋을까?

  • M1·M2 Mac mini에서 업그레이드하려는 사용자
  • 작고 조용한 개발 머신이 필요한 사람
  • Final Cut Pro, Logic Pro, Xcode 작업을 한 기기에서 처리하는 사용자
  • LM Studio, Ollama, MLX 등으로 로컬 AI를 실행하려는 사람
  • 24시간 가까이 켜두는 개인 AI 서버나 자동화 머신이 필요한 사용자

M4 사용자는 바꿔야 할까?

M4 Mac mini를 이미 가지고 있다면 이야기가 달라집니다.

웹, 문서, 일반 코딩 위주라면 M4도 여전히 매우 빠릅니다. AI 작업을 거의 하지 않는다면 M6로 바꾸는 체감이 가격 차이만큼 크지 않을 수 있습니다.

반대로 로컬 LLM, 이미지 생성, 에이전트, 코드 생성 같은 AI 작업이 중심이라면 M6의 메모리 대역폭과 GPU 구조 변화는 꽤 매력적입니다.

Apple 공식 영상

YouTube – Apple: The new Mac mini with M6

Apple 공식 영상에서는 최대 40% 빠른 CPU, 최대 2배 그래픽, 최대 4배 AI 성능을 중심으로 M6 Mac mini를 소개합니다.

그런데 진짜 중요한 질문은 따로 있습니다

AI 목적으로 Mac mini를 산다면 CPU 코어 수보다 더 중요한 것이 있습니다.

16GB? 24GB? 32GB?

Apple Silicon에서는 이 메모리가 CPU만 쓰는 RAM이 아닙니다. GPU도 같은 메모리를 공유합니다.

그래서 다음 2부에서는 Mac mini의 통합 메모리가 왜 로컬 LLM에 유리한지, 16GB·24GB·32GB에서 실제로 어느 크기의 모델까지 가능한지, M6와 RTX GPU의 차이가 무엇인지를 집중적으로 살펴보겠습니다.

7B, 13B, 70B는 무슨 뜻일까? 내 그래픽카드로 돌릴 수 있는 AI 모델 찾기

로컬 AI를 처음 시작하면 모델 이름부터 암호처럼 보입니다.

7B, 13B, 27B, 70B… 도대체 B는 무엇일까?

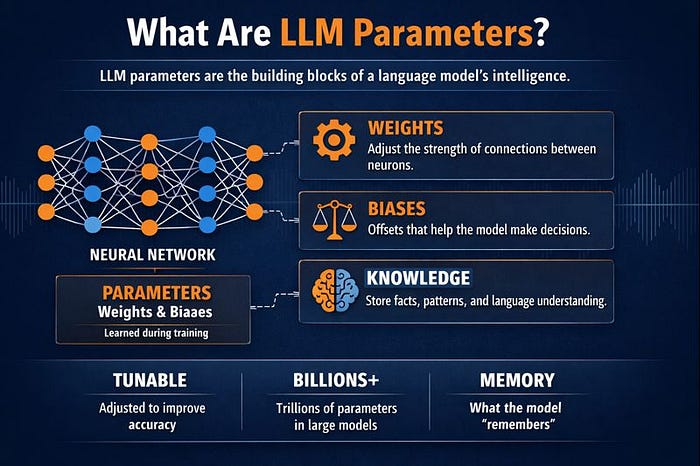
결론부터 말하면 B는 Billion, 즉 10억을 뜻합니다. 7B 모델은 약 70억 개, 13B는 약 130억 개, 70B는 약 700억 개의 파라미터를 가진 모델이라는 뜻입니다.

파라미터 70억 개? AI 머릿속의 아주 작은 다이얼 70억 개

파라미터(parameter)는 AI가 학습 과정에서 조정한 숫자입니다. 하나하나는 작은 숫자지만 수십억 개가 모이면 언어의 패턴과 관계를 표현하는 거대한 모델이 됩니다.

그래서 7B에서 숫자 7은 단순한 버전 번호가 아닙니다. 대략적인 모델 규모와 필요한 메모리를 짐작하게 해주는 첫 번째 힌트입니다.

LLM 파라미터와 신경망을 설명하는 그림
수십억 개의 파라미터가 모여 하나의 언어 모델을 구성합니다.

왜 7B 모델이 7GB가 아닐까?

FP16에서는 파라미터 하나를 저장하는 데 2바이트가 필요합니다. 따라서 가중치만 단순 계산하면:

  • 7B × 2바이트 ≈ 14GB
  • 13B × 2바이트 ≈ 26GB
  • 70B × 2바이트 ≈ 140GB

그리고 실제 추론에는 모델 가중치만 필요한 것이 아닙니다. KV cache, 컨텍스트 길이, 런타임 버퍼 같은 추가 공간도 필요합니다. NVIDIA 역시 LLM의 GPU 메모리를 좌우하는 주요 요소로 모델 가중치와 KV cache를 설명합니다.

참고: NVIDIA – Mastering LLM Techniques: Inference Optimization

그런데 7B 모델을 8GB 그래픽카드에서도 돌린다는데요?

여기서 등장하는 비밀 무기가 양자화(Quantization)입니다.

FP16이 파라미터 하나를 16비트로 표현한다면, 8비트나 4비트로 줄여 저장할 수도 있습니다. 일종의 압축 이사입니다. 큰 가구를 조금 작게 접어 VRAM이라는 방 안에 넣는 셈입니다.

4비트라면 이론상 파라미터 하나가 약 0.5바이트이므로 7B 모델의 순수 가중치는 약 3.5GB 수준까지 줄어듭니다. 물론 실제 실행에는 추가 메모리가 필요합니다. NVIDIA도 4비트 양자화된 27B 모델의 가중치를 약 13.5GB로 설명하며 별도 오버헤드가 필요하다고 안내합니다.

참고: NVIDIA – Accelerating Larger LLMs Locally

그럼 내 그래픽카드는 어디까지 가능할까?

예를 들어 GeForce RTX 4070 Ti SUPER 16GB를 가지고 있다고 해보겠습니다. 16GB VRAM은 로컬 AI 입문용으로 꽤 재미있는 구간입니다.

모델 규모 FP16 단순 가중치 4bit 단순 가중치 16GB GPU에서
7B 약 14GB 약 3.5GB 4bit 매우 여유로운 편
13B 약 26GB 약 6.5GB 4bit 현실적인 선택
27B 약 54GB 약 13.5GB 4bit도 설정에 따라 빠듯
70B 약 140GB 약 35GB 전체 GPU 적재는 어려움

표의 4bit 수치는 가중치만 단순 계산한 값입니다. 실제 필요한 VRAM은 모델 구조, 양자화 형식, 컨텍스트 길이, KV cache, 실행 프로그램에 따라 달라집니다.

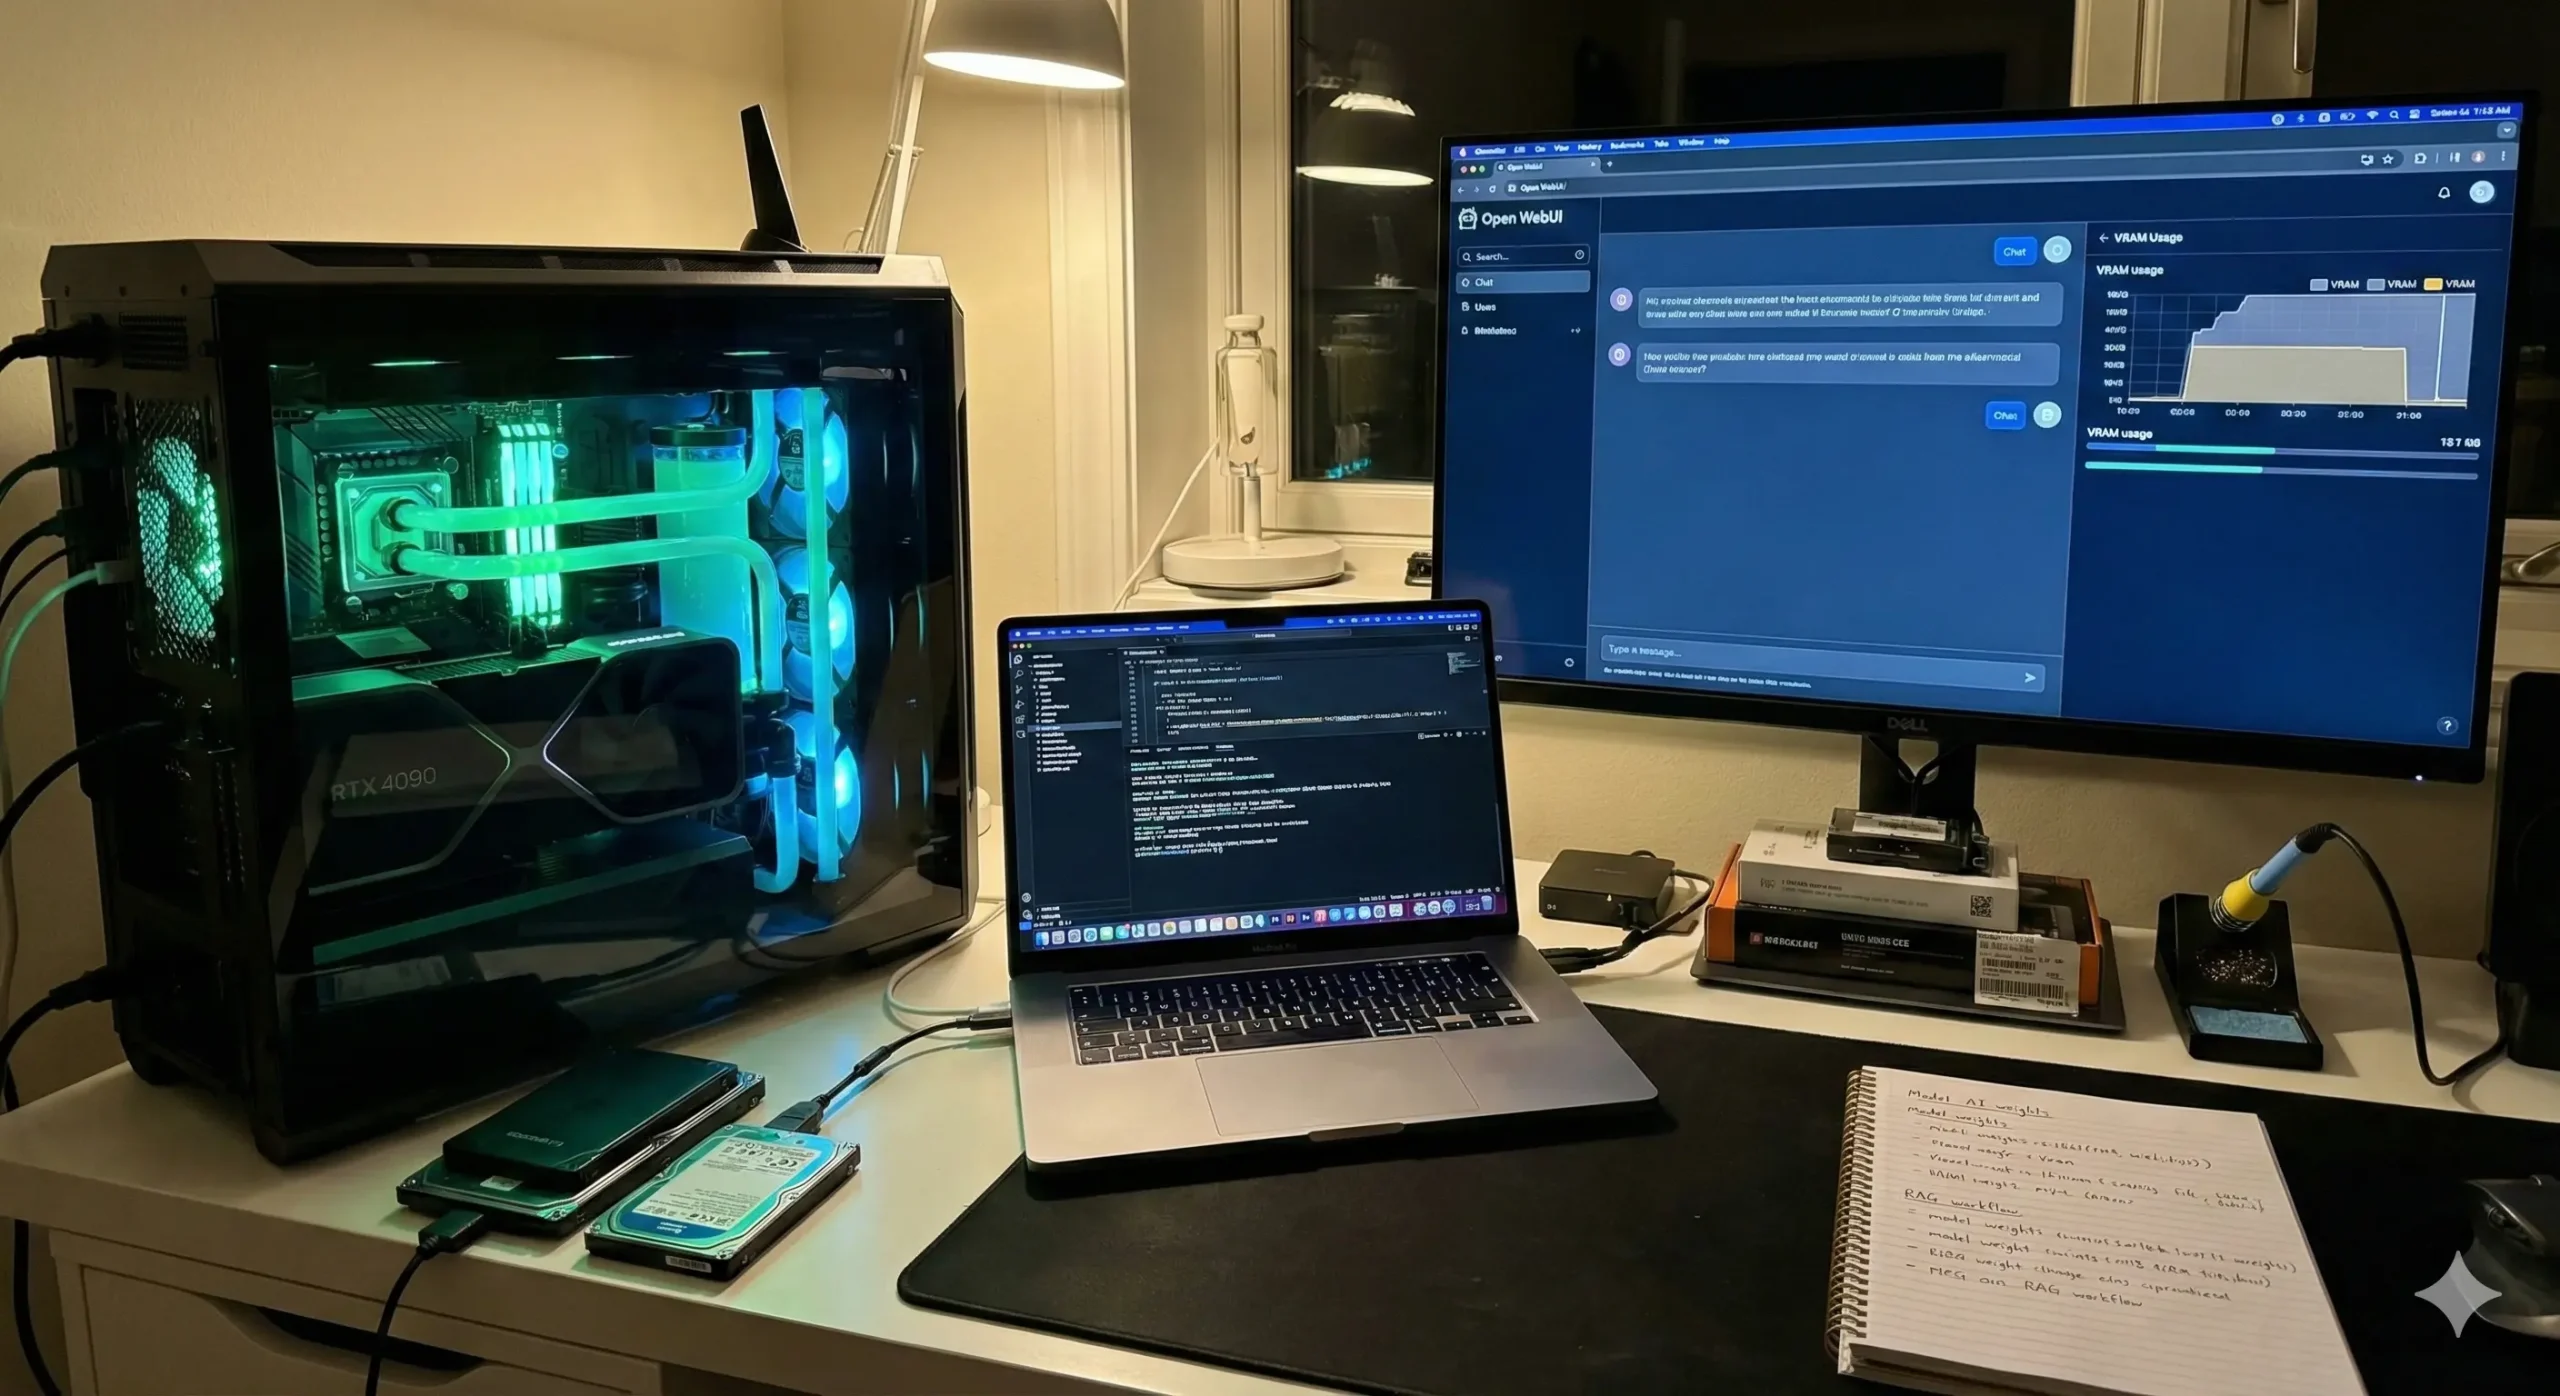
로컬 LLM 실행 화면과 GPU VRAM 사용량
로컬 LLM에서는 모델 크기, 양자화, GPU Offload와 VRAM 사용량을 함께 보게 됩니다.

16GB를 넘으면 끝인가요? 아닙니다

모델 전체가 VRAM에 들어가지 않아도 일부 레이어를 시스템 RAM과 CPU에 맡기는 GPU Offloading 방법이 있습니다. LM Studio나 llama.cpp 계열 도구에서 자주 만날 수 있습니다.

다만 “실행된다”와 “쾌적하다”는 다른 이야기입니다. VRAM에 모델이 잘 들어갈수록 일반적으로 GPU의 속도를 더 잘 활용할 수 있습니다.

Hugging Face는 AI 모델 창고

로컬 AI를 하다 보면 결국 Hugging Face를 만나게 됩니다. 개발자 입장에서는 AI 모델이 진열된 거대한 앱스토어이자 GitHub 같은 공간이라고 생각하면 쉽습니다.

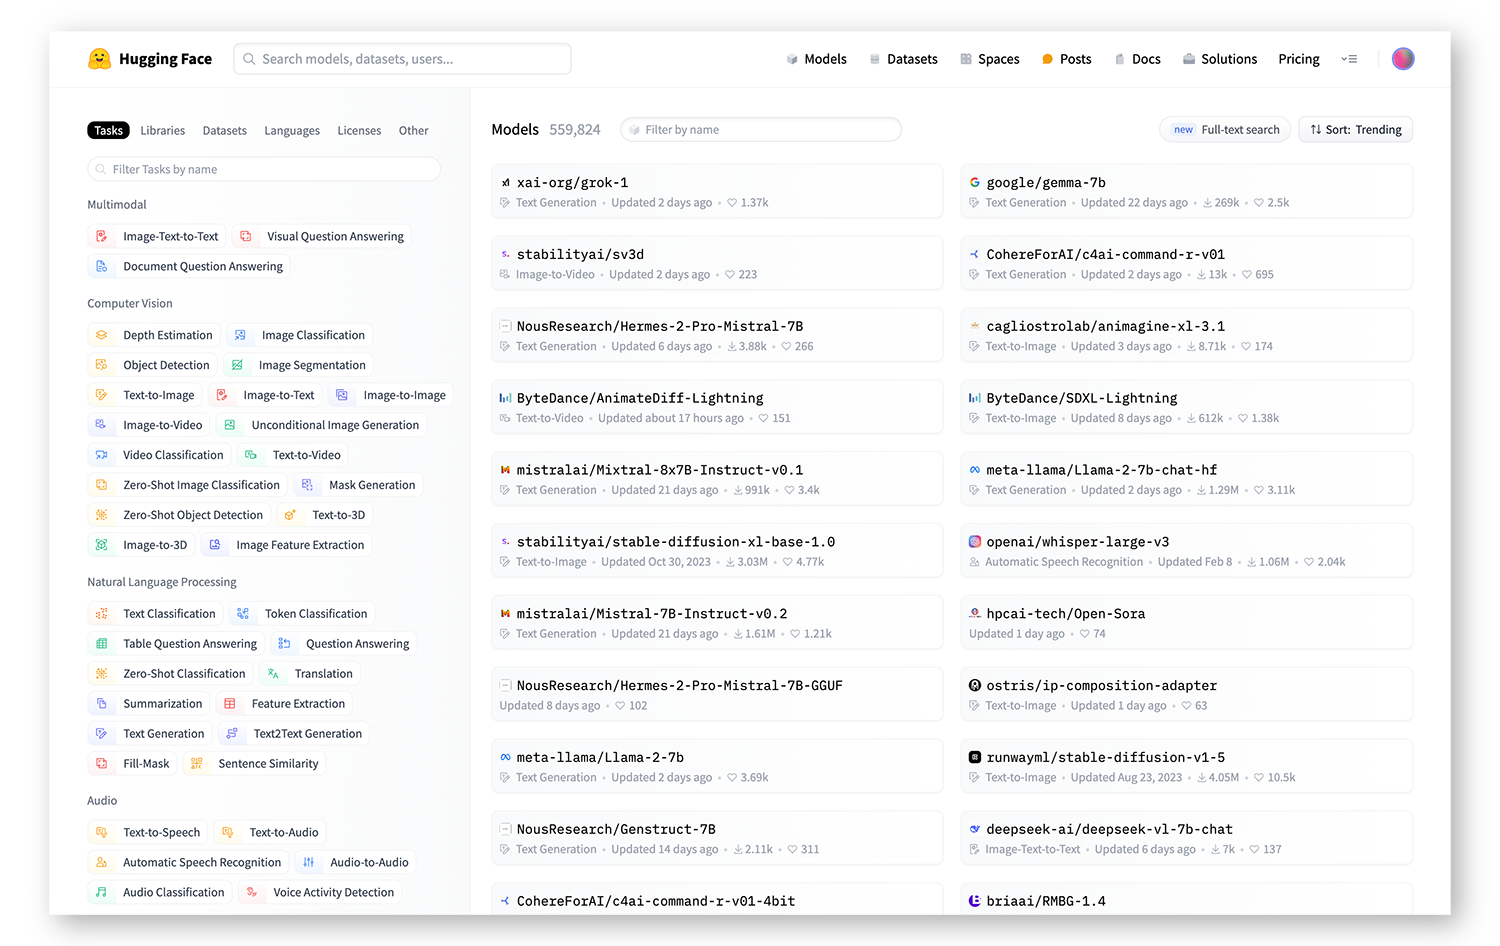
Hugging Face 모델 검색 화면
Hugging Face에서는 수많은 공개 모델을 검색하고 모델 카드와 파일을 확인할 수 있습니다.

초보자가 모델을 고를 때 먼저 볼 것

  1. 모델 크기: 7B, 8B, 13B, 14B처럼 파라미터 규모를 확인합니다.
  2. 파일 형식: llama.cpp나 LM Studio를 쓴다면 GGUF가 편리합니다.
  3. 양자화: Q4_K_M 같은 4bit 계열은 용량과 품질의 균형 때문에 자주 선택됩니다.
  4. 라이선스: 상업적 이용 여부와 사용 조건을 반드시 확인합니다.
  5. Model Card: 어떤 용도로 만든 모델인지, 필요한 실행 방법이 무엇인지 읽어봅니다.

Hugging Face에서 가장 간단하게 다운로드하기

Python이 설치되어 있다면 터미널에서 Hugging Face CLI를 사용할 수 있습니다.

pip install -U huggingface_hub

그 다음 원하는 모델 저장소를 찾았다면 다음처럼 받을 수 있습니다.

hf download HuggingFaceH4/zephyr-7b-beta

특정 폴더에 저장하고 싶다면:

hf download HuggingFaceH4/zephyr-7b-beta --local-dir ./models/zephyr-7b

Hugging Face 공식 문서에 따르면 hf download는 단일 파일뿐 아니라 저장소 전체도 받을 수 있고, --local-dir로 저장 위치를 지정할 수 있습니다.

공식 가이드: Hugging Face – Downloading models

Python 코드로 모델 전체를 받고 싶다면?

from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="HuggingFaceH4/zephyr-7b-beta",
    local_dir="./models/zephyr-7b"
)

snapshot_download()는 모델 저장소의 스냅샷을 내려받고 여러 파일을 병렬로 처리합니다. 필요한 파일만 선택하거나 제외하는 것도 가능합니다.

공식 가이드: Hugging Face Hub 다운로드 가이드

다운로드 버튼을 누르기 전에 파일 크기 확인하기

70B라는 숫자를 보고 “일단 받아보자!”라고 누르면 SSD가 먼저 놀랄 수 있습니다.

모델 페이지의 Files and versions에서 실제 파일 크기를 확인하고, GGUF라면 Q4, Q5, Q8 등 어떤 양자화 파일인지 살펴보는 습관이 좋습니다.

정리: 모델 이름을 보면 내 GPU에서 돌릴 수 있을까

이제 모델 이름에 붙은 7B나 70B가 조금 다르게 보일 겁니다.

B는 모델의 덩치를 알려주는 표지판이고, 양자화는 그 덩치를 줄이는 압축 기술이며, VRAM은 모델이 올라가 일할 작업대입니다.

16GB VRAM 그래픽카드를 가지고 있다면 처음부터 70B를 붙잡기보다 7B~14B급 4bit 모델부터 시작해보는 것이 이해도 쉽고 속도도 즐길 만합니다. 이후 20B~30B급을 시험하면서 GPU Offload와 컨텍스트 길이가 성능에 어떤 영향을 주는지 직접 확인하면 로컬 AI가 갑자기 훨씬 재미있어집니다.

왜 우리는 로컬 AI를 돌리기 위해 값비싼 그래픽카드를 사야 할까?

요즘 AI를 직접 내 PC에서 돌려보고 싶다는 생각을 하는 분들이 많습니다. ChatGPT처럼 대화하는 AI, Stable Diffusion 같은 이미지 생성 AI, 영상 생성 모델까지 이제는 개인 PC에서도 실행할 수 있습니다.

그런데 막상 시작하려고 보면 한 가지 벽을 만납니다.

“왜 AI 좀 돌리려는데 그래픽카드가 이렇게 비싸지?”

게임을 하지 않는 사람이라면 더 이상합니다. 그래픽카드는 원래 게임 화면을 예쁘게 보여주는 장치라고 생각했는데, 왜 인공지능 시대가 되자 갑자기 가장 중요한 부품이 되었을까요?

결론부터 말하면, AI는 ‘엄청난 양의 계산’을 동시에 처리해야 하기 때문입니다

CPU는 매우 똑똑한 만능 사무원에 가깝습니다. 복잡한 일을 순서대로 처리하는 데 강합니다. 반면 GPU는 수천 명의 계산원이 한꺼번에 같은 종류의 계산을 처리하는 구조입니다.

AI의 핵심 연산은 대부분 거대한 행렬 계산입니다. 숫자 수백만 개를 곱하고 더하는 작업이 반복됩니다. 이런 작업에서는 CPU보다 GPU가 훨씬 효율적입니다.

그래서 GPU는 게임용 부품에서 시작했지만, 지금은 AI 연산의 핵심 엔진이 되었습니다.

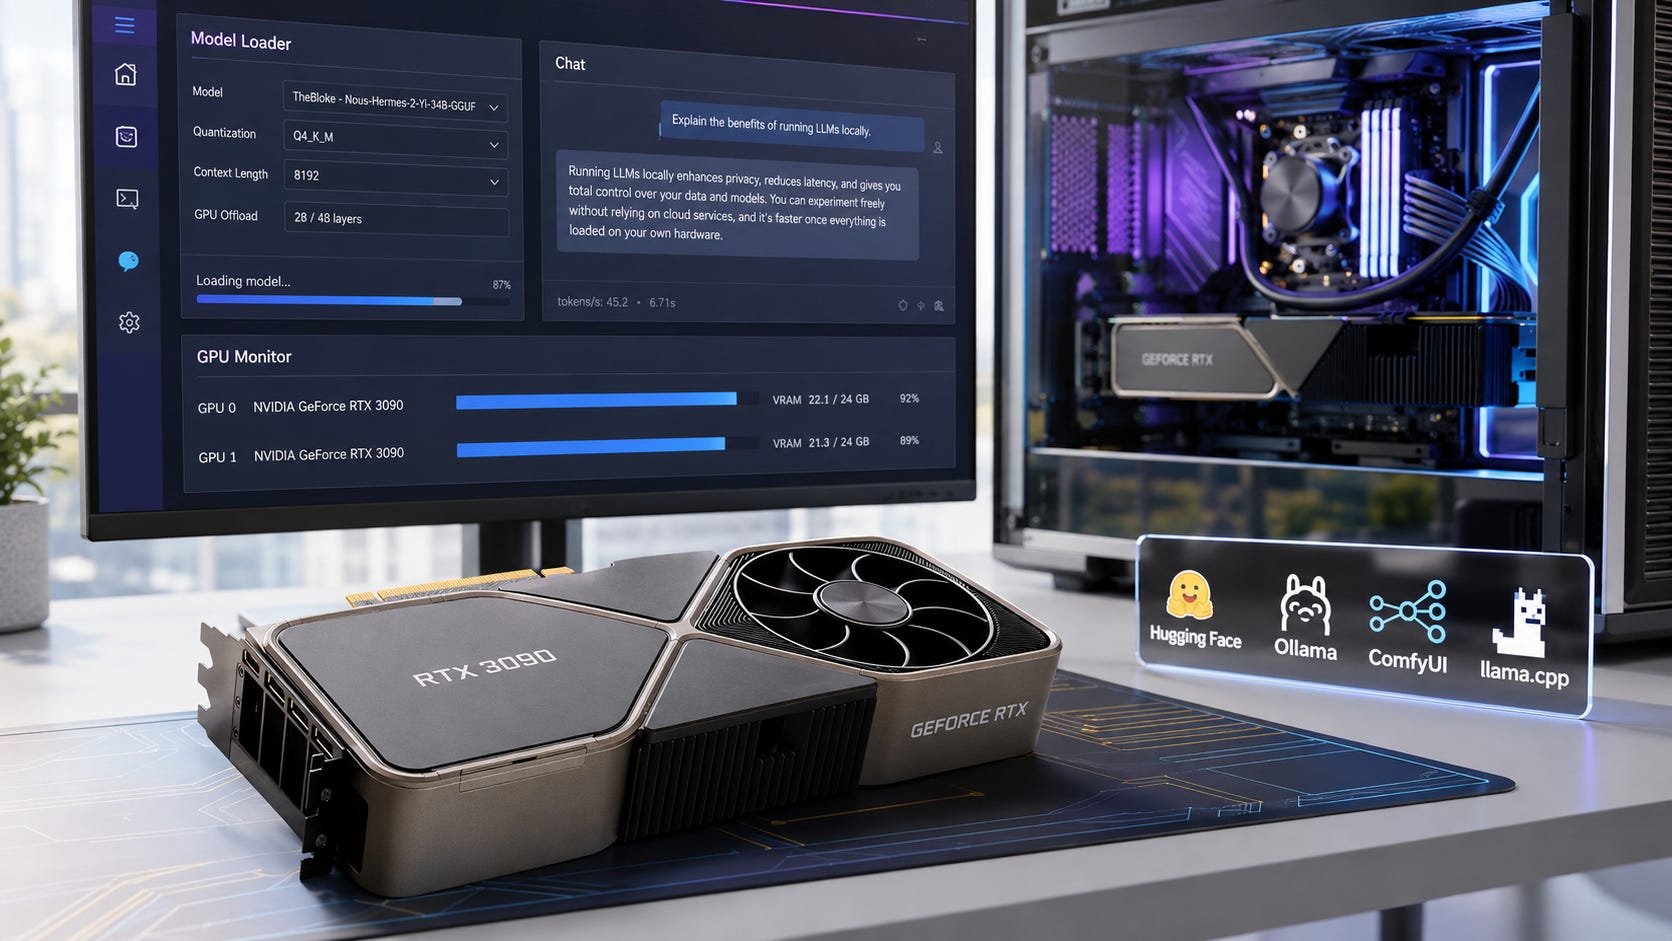
로컬 AI를 실행하는 GPU 워크스테이션과 모니터
GPU가 들어간 PC 한 대가 이제는 작은 개인 AI 연구실 역할까지 합니다.

그런데 GPU 성능보다 더 중요한 것이 있습니다. 바로 VRAM입니다

로컬 AI를 처음 시작할 때 많은 분들이 CUDA 코어 수, 클럭, 벤치마크 점수만 봅니다. 하지만 실제로 AI를 실행하다 보면 먼저 부딪히는 한계는 종종 VRAM 용량입니다.

VRAM은 그래픽카드 안에 붙어 있는 전용 메모리입니다. 게임에서는 고해상도 텍스처, 프레임 버퍼 등을 저장하고, AI에서는 모델의 가중치와 연산 중 필요한 데이터를 담습니다.

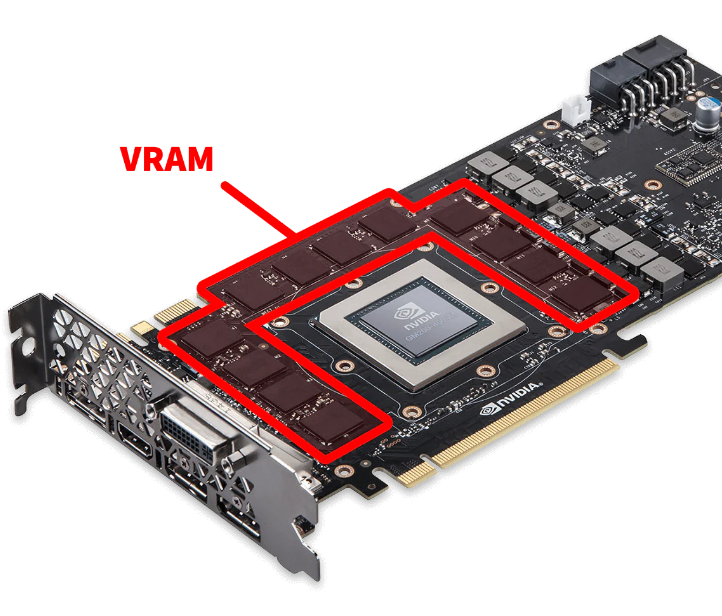
그래픽카드 PCB에서 VRAM 위치를 표시한 이미지
GPU 주변에 배치된 VRAM 메모리 칩. 로컬 AI에서는 이 공간이 매우 중요합니다.

NVIDIA는 VRAM을 GPU가 빠르게 접근할 수 있는 고속 메모리라고 설명합니다. 게임뿐 아니라 생성형 AI에서도 VRAM 크기는 실행 가능한 모델 크기와 직결됩니다.

AI 모델은 사실 ‘거대한 숫자 덩어리’입니다

LLM에서 자주 보는 7B, 13B, 70B 같은 숫자는 모델의 파라미터 수를 뜻합니다. 예를 들어 7B 모델은 약 70억 개의 파라미터를 가진 모델입니다.

이 숫자들을 메모리에 올려야 AI가 계산을 시작할 수 있습니다.

예를 들어 FP16 형식에서는 파라미터 하나에 약 2바이트가 필요합니다. 단순 계산으로만 보면 70억 개라면 약 14GB입니다. 여기에 실행 중 필요한 추가 메모리까지 포함되면 요구량은 더 커집니다.

NVIDIA 기술 문서에서도 7B 모델을 FP16으로 실행하거나 학습하는 경우 상당한 GPU 메모리가 필요하다고 설명합니다.

그래서 8GB 그래픽카드에서는 실행하기 어려운 모델이 16GB에서는 돌아가고, 24GB 이상에서는 훨씬 여유롭게 동작하는 상황이 생깁니다.

그런데 여기서 궁금해집니다. “7B가 정확히 뭐고, 내가 가진 그래픽카드로는 몇 B까지 돌릴 수 있을까?” 이 부분은 별도의 입문 글에서 7B·13B·70B, FP16과 4bit 양자화, VRAM 계산법부터 Hugging Face에서 실제 모델을 내려받는 방법까지 이어서 정리했습니다. 7B·13B·70B는 무슨 뜻일까? 내 그래픽카드로 돌릴 수 있는 AI 모델 찾기

VRAM은 책상 크기라고 생각하면 쉽습니다

AI 모델을 거대한 설계도라고 생각해보겠습니다.

VRAM은 그 설계도를 펼쳐놓는 책상입니다.

책상이 충분히 크면 모든 자료를 한 번에 펼쳐놓고 빠르게 작업할 수 있습니다. 하지만 책상이 좁으면 자료를 계속 서랍에 넣었다 꺼내야 합니다.

AI에서도 비슷합니다. 모델이 VRAM에 전부 올라가지 않으면 일부 데이터를 시스템 RAM이나 CPU 쪽으로 넘겨야 합니다. 이것을 GPU Offloading이라고 부릅니다.

실행은 가능해질 수 있지만 속도는 크게 느려질 수 있습니다.

게임에서 VRAM이 중요했던 이유가 AI에서도 그대로 이어집니다

고사양 게임에서도 4K 해상도, 고해상도 텍스처, 레이트레이싱을 사용하면 VRAM 사용량이 크게 증가합니다.

고사양 게임 화면과 GPU 사용률 표시
게임에서도 고해상도 그래픽 데이터 때문에 GPU와 메모리가 크게 사용됩니다.

AI 역시 마찬가지입니다. 다만 게임이 텍스처와 프레임 데이터를 올린다면, AI는 수십억 개의 파라미터를 올린다는 차이가 있습니다.

즉 게임 시대에 GPU가 ‘화면을 만드는 엔진’이었다면, AI 시대에는 ‘생각을 계산하는 엔진’ 역할까지 맡게 된 셈입니다.

그래서 NVIDIA가 AI 시대의 핵심 기업이 되었습니다

GPU는 원래 그래픽 처리용으로 발전했지만, 병렬 연산이라는 특성이 딥러닝과 매우 잘 맞았습니다. NVIDIA는 CUDA 생태계를 통해 개발자가 GPU를 AI 연산에 활용하기 쉽게 만들었습니다.

CES 2017 기조연설자로 나서는 엔비디아의 젠슨 황 CEO - NVIDIA Blog Korea

이 때문에 오늘날 PyTorch, TensorFlow, Stable Diffusion, LLM 추론 도구 등 수많은 AI 소프트웨어가 NVIDIA GPU에 최적화되어 있습니다.

그렇다면 무조건 가장 비싼 그래픽카드를 사야 할까요?

그렇지는 않습니다. 중요한 것은 내가 어떤 AI를 돌릴 것인가입니다.

  • 가벼운 로컬 LLM: 8GB~12GB VRAM에서도 양자화 모델을 활용하면 충분히 경험할 수 있습니다.
  • Stable Diffusion, SDXL: 12GB~16GB 정도면 꽤 편하게 사용할 수 있습니다.
  • 조금 더 큰 LLM, 이미지 생성, 영상 생성: 16GB 이상이 확실히 유리합니다.
  • 대형 LLM, 학습, 고해상도 영상 생성: 24GB 이상 또는 여러 GPU가 필요할 수 있습니다.

최근에는 4비트, 8비트 양자화를 이용해 모델 크기를 크게 줄일 수 있습니다. 덕분에 과거에는 24GB VRAM이 필요했던 모델을 더 적은 메모리에서도 실행할 수 있습니다.

CPU와 RAM이 많으면 GPU 없이도 가능하지 않을까요?

가능합니다.

실제로 llama.cpp 같은 도구는 CPU만으로도 LLM을 실행할 수 있습니다. Apple Silicon처럼 통합 메모리를 사용하는 시스템도 로컬 AI에서 상당히 매력적입니다.

하지만 속도 차이는 분명합니다.

AI에서 중요한 것은 단순히 “돌아가느냐”가 아니라 얼마나 빠르게 결과가 나오느냐입니다.

이미지 한 장을 만드는 데 5초가 걸리는 것과 2분이 걸리는 것은 체감이 완전히 다릅니다. 영상 생성에서는 이 차이가 몇 분과 몇 시간으로 벌어질 수도 있습니다.

그래픽카드 가격이 비싼 진짜 이유

결국 우리가 비싼 GPU를 사는 이유는 단순히 FPS를 높이기 위해서가 아닙니다.

GPU에는 다음과 같은 요소가 동시에 들어갑니다.

  • 수천 개의 병렬 연산 코어
  • AI 전용 Tensor Core
  • 고속 VRAM
  • 매우 높은 메모리 대역폭
  • 복잡한 전력 및 냉각 설계

특히 VRAM은 단순한 저장 공간이 아닙니다. GPU가 초당 수백 GB 이상의 데이터를 주고받을 수 있도록 설계된 매우 빠른 메모리입니다.

로컬 AI의 가장 큰 장점은 ‘내 컴퓨터에서 돌아간다’는 것입니다

그렇다면 클라우드 AI를 쓰면 되지 않을까요?

물론 대부분의 사람에게는 ChatGPT, Gemini, Claude 같은 서비스가 훨씬 편합니다.

하지만 로컬 AI에는 분명한 장점이 있습니다.

  • 인터넷 없이 사용할 수 있습니다.
  • 개인 데이터가 외부 서버로 나가지 않습니다.
  • API 비용을 계속 지불하지 않아도 됩니다.
  • 모델을 자유롭게 수정하고 실험할 수 있습니다.
  • 자동화 시스템과 직접 연결하기 쉽습니다.

특히 개발자나 AI를 직접 연구하고 싶은 사람에게 로컬 AI는 하나의 작은 개인 연구실이 됩니다.

초보자가 그래픽카드를 고를 때는 ‘성능’보다 VRAM부터 보세요

로컬 AI를 목적으로 그래픽카드를 구입한다면 다음 순서로 보는 것이 좋습니다.

  1. VRAM 용량
  2. CUDA 및 AI 소프트웨어 호환성
  3. Tensor Core 세대
  4. 메모리 대역폭
  5. 전력 소비와 가격

게임 벤치마크에서 조금 더 빠른 GPU보다 VRAM이 더 많은 GPU가 AI에서는 오히려 더 유용한 경우가 많습니다.

마무리: AI 시대의 그래픽카드는 새로운 형태의 컴퓨터입니다

과거에는 좋은 그래픽카드를 사는 이유가 분명했습니다.

게임을 더 높은 해상도와 더 높은 FPS로 즐기기 위해서였습니다.

하지만 AI 시대에는 의미가 달라졌습니다.

그래픽카드는 이제 단순히 화면을 그리는 장치가 아니라 이미지 생성, 영상 생성, 음성 합성, LLM 추론까지 담당하는 작은 병렬 컴퓨터가 되었습니다.

그리고 그 컴퓨터의 작업 공간이 바로 VRAM입니다.

그래서 로컬 AI를 시작하면 자연스럽게 이런 생각을 하게 됩니다.

“GPU가 얼마나 빠른가?”보다 먼저 “VRAM이 얼마나 큰가?”

아마 AI를 직접 돌려본 사람이라면 이 말이 꽤 빠르게 이해될 것입니다.


핵심 키워드: 로컬 AI, GPU, VRAM, 그래픽카드, LLM, Stable Diffusion, 생성형 AI, NVIDIA, CUDA

Claude Opus 5.5 출시: 주요 기능과 API 가격, 달라진 점 정리

AI를 업무에 활용할 때 중요한 것은 답변의 품질과 작업을 마치는 데 필요한 시간, 비용입니다. 앤트로픽이 2026년 9월 22일 공개한 Claude Opus 5.5는 이 세 가지의 개선을 내세운 모델입니다. 이번 글에서는 공식 발표를 바탕으로 주요 기능과 가격, 활용 방법을 살펴봅니다.

Claude Opus 5.5, 무엇이 달라졌나요?

앤트로픽은 Opus 5.5의 주요 변화로 복잡한 작업 수행 능력, 처리 효율, 명확한 설명을 강조합니다. 공식 발표에 따르면 Opus 5 대비 출력 생성 속도가 30% 이상 빨라졌으며, 일반적인 작업의 실행 비용은 기본 설정에서 약 40% 줄어듭니다. 이는 회사 측 평가 결과이며 실제 작업마다 차이가 있습니다. [1]

1. 큰 프로젝트를 다루는 코딩 기능

공식 제품 설명에 따르면 여러 파일에 걸친 기능 개발, 디버깅, 리팩터링, 코드 리뷰에 대응합니다. 문제의 원인을 찾고 수정 결과를 점검하며, 변경 내용을 이해하기 쉽게 설명하는 데 초점을 맞췄습니다. [2]

활용 예시로는 배치 프로그램의 오류 원인을 로그와 코드로 함께 분석하거나, 오래된 모듈의 수정 범위와 테스트 항목을 정리하는 작업을 생각할 수 있습니다. 운영 반영 전에는 기존 결과와의 비교가 필요합니다.

중앙의 AI를 중심으로 코드 편집기와 여러 도구가 연결된 개념 이미지

2. 여러 도구를 연결하는 AI 에이전트

에이전트는 목표를 수행하기 위해 도구를 사용하며 여러 단계를 진행하는 AI입니다. Opus 5.5는 작업 계획, 하위 에이전트 조율, 세션 간 메모리 활용 등 긴 작업을 이어가는 기능을 강조합니다. 실제 사용 범위는 연결한 도구와 실행 환경에 따라 달라집니다. [2]

3. 문서·차트 분석과 업무 결과물 작성

문서, 차트, 스크린샷을 해석하고 스프레드시트·발표자료·문서를 만드는 업무도 주요 활용 분야입니다. 핵심을 앞에 배치하고 사용자가 지정한 글쓰기 규칙을 따르는 설명 방식 역시 개선점으로 소개됐습니다. [2]

예를 들어 상품 비교 자료를 제공하고 구매 기준별 표와 블로그 초안을 요청할 수 있습니다. 가격·출시일 등 변동 정보는 원문과 대조하는 과정이 필요합니다.

노트북과 모니터 앞에서 문서와 차트를 검토하는 작업 공간

4. API 가격과 ‘40% 절감’의 의미

아래는 공식 발표의 표준 API 가격입니다. 단위는 100만 토큰당 미국 달러입니다. [1]

항목 Opus 5 Opus 5.5
입력 $5 $4
출력 $25 $20
캐시 읽기 $0.50 $0.20

40%는 모든 요금의 일괄 할인율이 아닙니다. 입력·출력 단가는 20%, 캐시 읽기는 60% 내려갔고, 작업당 토큰 사용량 감소까지 반영한 회사 측 추정치입니다. 구독료가 40% 인하됐다는 뜻도 아닙니다.

별도 Fast mode는 최대 2.5배 속도를 제공하며, 입력 $8·출력 $40으로 표준 모드보다 비쌉니다. [1]

어디에서 사용할 수 있나요?

공식 안내 기준으로 Claude의 Pro·Max·Team·Enterprise 이용자가 사용할 수 있습니다. 개발자는 Claude Platform과 AWS·Google Cloud·Microsoft Foundry에서 이용할 수 있으며, Claude API 모델 ID는 claude-opus-5-5입니다. [2]

실제 업무에서는 이렇게 비교해 보세요

도입 전에는 자주 하는 작업 하나를 골라 기존 모델과 동일한 자료·요구사항으로 비교해 보는 것이 좋습니다. 정답 여부와 함께 완료 시간, 재수정 횟수, 총비용을 기록하면 자신의 업무에서 개선 효과가 있는지 판단하기 쉽습니다.

확인 기준: 2026년 9월 29일. 직접 사용 후기가 아닌 공식 발표 기반 소개입니다.

참고 자료

Ai 뮤즈 (ai.meta) VPN 없이 가입 하는 방법

Ai뮤즈는 메타(Meta)가 2026년 9월 8일(현지시간) 공개한 뮤즈(Muse)는 질문에 답만 하는 기존 챗봇을 넘어, 사용자를 대신해 실제 작업을 수행하는 세계 최초의 개인 AI 에이전트(Agent)입니다. 현재국내 서비스가 아직 시작되지 않아서 대기등록만 해야하는데요 승인이 언제될지는 아직 미정입니다.

muse main 화면

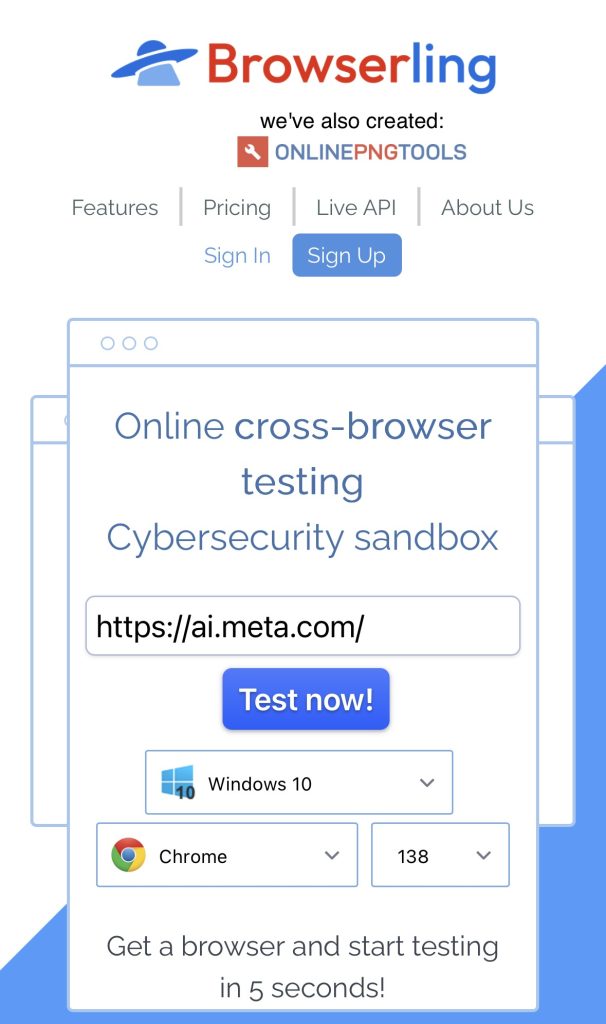
바로 사용 가능한 방법은 VPN 없이 쉽게 Browserling 사용하는 방법을 안내해 드립니다.

Browserling이 뭔가요?

• 웹 브라우저 안에서 또 다른 브라우저를 띄워주는 서비스 입니다. vpn없이 해외 사이트에 최대 3분간 머물 수 있습니다.

진행 순서

1. Browserling 접속

https://www.browserling.com 에 접속

2. muse.ai 접속

Browserling 안에서 https://ai.meta.com 입력. 앞에 띄워진 내부 팝업은 좌측으로 이동하면 브라우저가 보입니다.

3. 가입할 이메일 입력

• 기존 메타계정이 아닌 신규 신청하지 않은 신규 이메일로 진행해주세요

4. 이메일 인증

메일함에서 인증 완료해주세요.

5. 나이 인증용 카드 등록

• 신용카드 인증이 필요합니다. $1 결제 후 2~5일 뒤 환불 됩니다. 저는 다음 날 바로 환불됐어요

6. 1억 무료 토큰 받기

가입이 끝나면 1억 무료 토큰 을 받을 수 있어요!

추천인 코드 꼭 넣으세요!

추천인 코드를 입력하면 추천한 사람과 받은 사람 모두 토큰을 받아요!!

추천인 코드: 2U4C8T

토큰은 유효기간이 없어요! 급하게 쓰지 않아도 되니까 천천히 쓰셔도 됩니다!

Chat GPT-5.2 소개

“지적 노동에서 전문가를 넘는다”는 말은 과장이었을까

OpenAI가 2025년 12월, 최신 AI 모델 GPT-5.2를 공개했다.
OpenAI는 이 모델을 “전문 지식 노동과 장시간 에이전트 작업을 위한 가장 진보한 프런티어 모델”이라고 설명한다.

이 문장은 익숙하다.
AI 발표 때마다 반복되어 온 표현이기 때문이다.

하지만 GPT-5.2에 대해 업계가 주목하는 이유는 따로 있다.
이번에는 “더 똑똑해졌다”는 선언이 아니라, 이미 경제적 효과가 수치로 증명되고 있다는 점이다.

https://m.media-amazon.com/images/I/71svjlDsS4L._AC_UF1000%2C1000_QL80_.jpg?utm_source=chatgpt.com

이미 업무 시간은 줄어들고 있었다

OpenAI에 따르면,
평균적인 ChatGPT Enterprise 사용자는 이미 하루 40~60분의 시간을 절약하고 있으며,
헤비 유저의 경우 주당 10시간 이상을 AI로 절감하고 있다고 답했다.

GPT-5.2는 이 지점을 더 밀어붙이기 위해 설계됐다.

  • 스프레드시트 생성
  • 프레젠테이션 구성
  • 코드 작성과 리뷰
  • 이미지 이해
  • 긴 문맥 분석
  • 도구 호출과 다단계 프로젝트 처리

즉, GPT-5.2는 “답변을 잘하는 모델”이 아니라
실제 결과물을 만들어내는 모델에 가깝다.

GPT-5.2는 하나의 모델이 아니다

GPT-5.2는 용도에 따라 세 가지로 제공된다.

  • GPT-5.2 Instant
    일상 업무, 학습, 검색, 설명에 최적화된 고속 모델
  • GPT-5.2 Thinking
    복잡한 추론, 코드, 장문 문서, 다단계 의사결정을 위한 모델
  • GPT-5.2 Pro
    시간이 걸리더라도 정확성과 완성도를 최우선으로 하는 최상위 모델

이 구성은 OpenAI의 전략 변화를 보여준다.
“하나의 AI가 모든 것을 한다”는 환상에서,
업무 흐름에 맞춘 AI 분업 체계로 이동하고 있다는 신호다.

GPT-5.2 Thinking과 Pro는 실제로 얼마나 강해졌나

GPT-5.2에 대한 설명이 추상적으로 느껴진다면,
이제는 숫자를 볼 차례다.

OpenAI는 GPT-5.2 Thinking을 중심으로,
GPT-5.2 Pro의 일부 결과를 포함한 세부 벤치마크 점수를 공개했다.
이 평가는 단순 정답률이 아니라, 실제 업무·연구·엔지니어링 맥락을 기준으로 설계된 것이 특징이다.

전문 지식 노동 (Professional Work)

평가 항목GPT-5.2 ThinkingGPT-5.2 Pro이전 세대
GDPval (승·무 기준)70.9%74.1%38.8% (GPT-5)
GDPval (명확한 승리만)49.8%60.0%35.5%
투자은행 스프레드시트 과제68.4%71.7%59.1%

이 수치는 의미가 명확하다.
GPT-5.2 Thinking은 이미 다수의 지식 노동 과제에서 인간 전문가와 동급 이상이며,
Pro 모델은 그 안정성과 완성도를 더 끌어올린다.

특히 스프레드시트, 재무 모델링, 프레젠테이션 구성처럼
형식과 구조가 중요한 업무에서 개선 폭이 크다.

코딩 성능 (Coding)

평가 항목GPT-5.2 ThinkingGPT-5.2 ProGPT-5.1 Thinking
SWE-Bench Pro (Public)55.6%–50.8%
SWE-bench Verified80.0%–76.3%
SWE-Lancer IC Diamond74.6%–69.7%

SWE-Bench Pro는 실제 코드 저장소를 기반으로
“패치를 만들어 문제를 해결할 수 있는지”를 평가한다.

GPT-5.2 Thinking은 여기서 **새로운 최고점(SOTA)**을 기록했다.
이는 곧,

  • 대규모 코드베이스 리팩토링
  • 기능 구현
  • 버그 수정

같은 작업을 사람의 개입 없이 끝까지 밀고 갈 확률이 높아졌다는 뜻이다.

사실성 (Factuality)

평가 항목GPT-5.2 ThinkingGPT-5.1 Thinking
오류 없는 응답 (검색 사용)93.9%91.2%
오류 없는 응답 (검색 없음)88.0%87.3%

숫자 차이는 크지 않아 보이지만,
업무 현장에서는 이 2~3%가 재검토 비용과 신뢰도를 크게 바꾼다.

GPT-5.2는 “더 똑똑한 AI”라기보다
“덜 틀리는 AI”에 가까워졌다고 보는 편이 정확하다.

초장문 문맥 이해 (Long Context)

평가 항목GPT-5.2 ThinkingGPT-5.1 Thinking
MRCRv2 (8 needles, 4k–8k)98.2%65.3%
MRCRv2 (16k–32k)95.3%44.0%
MRCRv2 (128k–256k)77.0%29.6%

이 결과는 매우 상징적이다.
GPT-5.2는 256k 토큰 구간에서도 논리 붕괴 없이 정보를 유지한다.

즉, 이제 AI는

  • 계약서 수십 개
  • 보고서 수백 페이지
  • 대화 로그 전체

를 **“읽고, 기억하고, 다시 꺼내 쓸 수 있는 단계”**에 들어섰다.

비전(Vision) 이해

평가 항목GPT-5.2 ThinkingGPT-5.1 Thinking
CharXiv Reasoning (w/ Python)88.7%80.3%
ScreenSpot Pro (GUI 이해)86.3%64.2%

GPT-5.2는 단순 이미지 인식을 넘어,
**“화면의 구조와 맥락”**을 이해하기 시작했다.

이는 기술 지원, 운영 대시보드 분석, UI 리뷰 같은
실무 영역에서 특히 강력하다.

수학·과학·추론

평가 항목GPT-5.2 ThinkingGPT-5.2 ProGPT-5.1 Thinking
GPQA Diamond92.4%93.2%88.1%
AIME 2025100%100%94.0%
FrontierMath (Tier 1–3)40.3%–31.0%
ARC-AGI-252.9%54.2%17.6%

특히 ARC-AGI-2는 사전 지식이 통하지 않는 추상 추론 문제다.
여기서의 점프는 GPT-5.2가 단순 패턴 인식 모델을 넘어서
‘새 문제를 푸는 사고 구조’를 갖추기 시작했음을 보여준다.

이 숫자들이 말해주는 것

GPT-5.2는 모든 영역에서 “조금씩 좋아진 모델”이 아니다.

  • 지식 노동 → 전문가 수준 도달
  • 코딩 → 엔드투엔드 처리 가능
  • 문맥 → 사고의 지속성 확보
  • 비전 → 업무 화면 이해
  • 추론 → 새 문제 대응

즉, GPT-5.2는
“AI를 어디까지 맡길 수 있는가”라는 질문에 처음으로 실질적인 답을 제시한 모델이다.

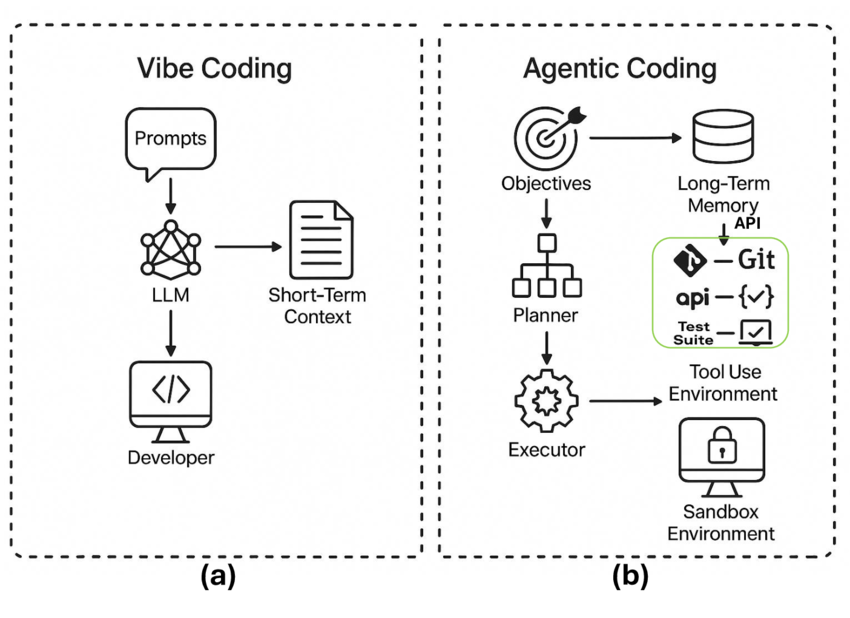
https://juanfernandopacheco.com/wp-content/uploads/2025/07/Comparative-Architecture-of-Vibe-Coding-and-Agentic-Coding-a-Vibe-Coding-Developers.png.webp?utm_source=chatgpt.com

환각이 줄었다는 말의 무게

GPT-5.2 Thinking은 환각(hallucination) 발생률도 줄였다.
실제 ChatGPT 질의 기준으로,
오류가 포함된 응답은 약 30% 상대적으로 감소했다.

숫자만 보면 작아 보일 수 있다.
그러나 업무에서 이 차이는 치명적이다.

  • 리서치
  • 분석
  • 의사결정 지원

이 영역에서 “조금 덜 틀린 AI”는
“훨씬 더 신뢰할 수 있는 AI”를 의미한다.

긴 문서, 이제는 진짜 ‘읽는다’

GPT-5.2 Thinking은 256k 토큰까지의 장문 문맥에서
거의 100%에 가까운 정확도를 기록했다.

계약서, 보고서, 연구 논문, 회의 기록처럼
수십만 토큰에 흩어진 정보를 하나의 논리로 엮는 작업이 가능해졌다.

이는 단순한 컨텍스트 확장이 아니라,
사고의 지속성이 확보됐다는 의미다.

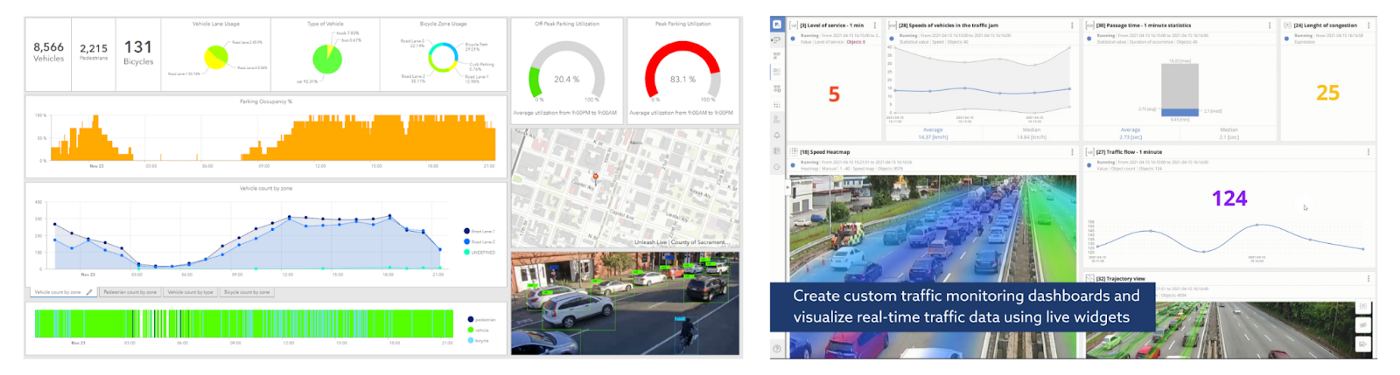
이미지와 화면을 이해하는 AI

GPT-5.2는 시각 인식에서도 큰 폭의 개선을 보였다.

  • 과학 논문 차트 해석
  • GUI 스크린샷 이해
  • 대시보드, 다이어그램 분석

특히 화면 요소의 상대적 위치를 이해하는 능력이 향상되면서,
기술 지원, 디자인 검토, 엔지니어링 업무에서 활용도가 높아졌다.

https://kajabi-storefronts-production.kajabi-cdn.com/kajabi-storefronts-production/blogs/22606/images/jAGN5RhsSv2j9XSjYVWN_0_Do9K8trN6MugxGK.png?utm_source=chatgpt.com
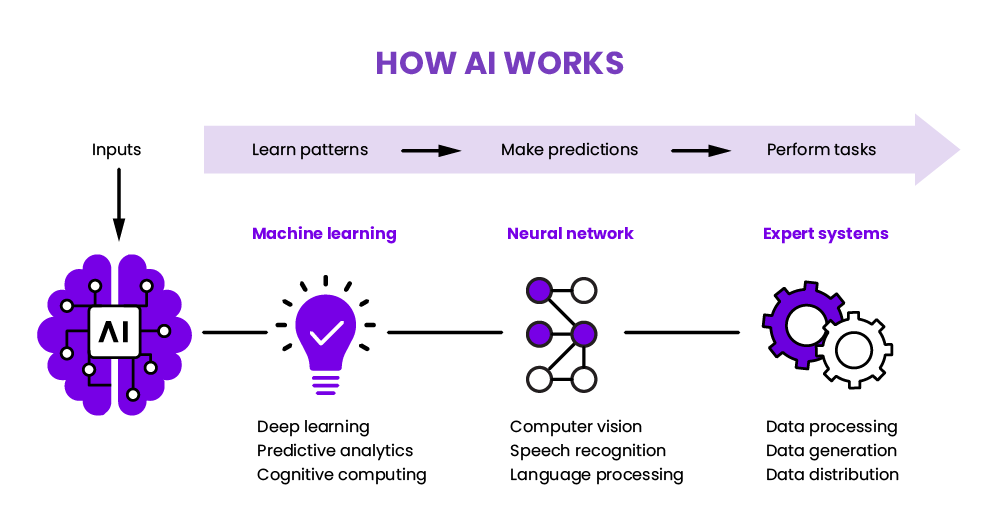
https://www.weka.io/wp-content/uploads/files/2023/06/ai-technology-diagram.png?utm_source=chatgpt.com

AI의 새 시대가 열렸다! 똑똑해진 Gemini 3.0과 함께하는 놀라운 일상

2025년 11월 18일. 구글(Google)의 Gemini 3.0 발표는 단순한 대규모 언어 모델(LLM)의 세대교체를 넘어, 인공지능이 수동적인 정보 처리 도구에서 능동적인 행위자(Agent)로 진화하는 중대한 변곡점을 시사한다. 지난 수년간 생성형 AI(Generative AI)는 텍스트와 이미지를 생성하는 창작의 도구로 자리 잡았으나, 복잡한 현실 세계의 문제를 해결하거나 다단계의 논리적 추론을 수행하는 데에는 한계를 보여왔다. Gemini 3.0은 이러한 한계를 극복하기 위해 설계된 구글 딥마인드(Google DeepMind)의 야심 찬 프로젝트로, ‘추론(Reasoning)’과 ‘에이전트(Agent)’라는 두 가지 핵심 축을 중심으로 AI의 정의를 재정립하고 있다. 

Gemini 3.0의 아키텍처 진화와 기술적 기반

Gemini 3.0은 이전 세대인 Gemini 1.0의 멀티모달 기초와 Gemini 2.0의 도구 사용 능력을 통합하고 확장한 결과물이다. 이 모델은 텍스트, 이미지, 오디오, 비디오, 코드 등 서로 다른 유형의 데이터를 별도의 변환 과정 없이 네이티브(Native)하게 이해하고 처리할 수 있는 진정한 의미의 멀티모달 아키텍처를 갖추고 있다.   

– 네이티브 멀티모달리티(Native Multimodality)와 컨텍스트 처리

Gemini 3.0의 가장 큰 특징 중 하나는 100만 토큰(1 million tokens)에 달하는 방대한 컨텍스트 윈도우(Context Window)를 기본적으로 지원한다는 점이다. 이는 단순히 많은 양의 텍스트를 기억하는 것을 넘어, 수 시간 분량의 비디오, 수천 페이지의 문서, 거대한 코드베이스를 단일 컨텍스트 내에서 통합적으로 분석하고 추론할 수 있음을 의미한다. 기존 모델들이 외부 검색(RAG)이나 요약에 의존해야 했던 대규모 정보 처리 작업을 단일 추론 과정으로 처리함으로써 정보의 손실을 최소화하고 맥락의 연속성을 유지한다.   

특히, Gemini 3.0은 비디오와 오디오 처리에 있어 비약적인 발전을 이루었다. ‘Video-MMMU’ 벤치마크에서 87.6%의 점수를 기록하며 경쟁 모델들을 압도했는데, 이는 영상 내의 시각적 정보와 청각적 정보를 결합하여 장면의 인과관계를 이해하고, 특정 사건이 발생한 시점을 정확히 찾아내거나 복잡한 행동을 분석하는 능력이 인간 전문가 수준에 도달했음을 시사한다.   

– 추론(Reasoning) 중심의 설계: 시스템 1에서 시스템 2로

Gemini 3.0 아키텍처의 핵심은 ‘추론’ 능력의 강화이다. 인간의 인지 과정에 비유하자면, 기존의 LLM이 직관적이고 빠른 응답을 생성하는 ‘시스템 1(System 1)’ 사고에 치중했다면, Gemini 3.0은 논리적이고 분석적인 단계를 거치는 ‘시스템 2(System 2)’ 사고를 구현하는 데 주력했다. 이는 모델이 복잡한 질문에 직면했을 때, 즉시 답변을 내놓는 대신 내부적으로 사고하는 과정(Chain of Thought)을 거치도록 설계되었음을 의미한다.   

이러한 설계 철학은 모델이 사용자의 의도(Intent)와 미묘한 뉘앙스(Nuance)를 파악하는 데 결정적인 역할을 한다. 사용자가 불완전하거나 모호한 프롬프트를 입력하더라도, Gemini 3.0은 문맥을 통해 숨겨진 의도를 유추하고 최적의 결과를 도출할 수 있다. 구글은 이를 통해 사용자가 복잡한 프롬프트 엔지니어링(Prompt Engineering) 없이도 AI를 효과적으로 활용할 수 있는 ‘Less Prompting’ 시대를 예고하고 있다.   

모델 라인업 및 핵심 기능 심층 분석

Gemini 3.0은 범용성과 특수 목적을 아우르는 모델 패밀리로 구성되어 있으며, 각 모델은 특정 사용 사례에 최적화된 성능을 제공한다.

– Gemini 3 Pro: 차세대 범용 지능의 표준

Gemini 3 Pro는 균형 잡힌 성능과 효율성을 제공하는 미드레인지급 이상의 모델로, 광범위한 자연어 처리, 코딩, 멀티모달 작업에 최적화되어 있다. 특히, 이 모델은 ‘Google AI Studio’와 ‘Vertex AI’를 통해 개발자와 기업에 제공되며, 실시간성(Latency)과 추론 깊이 사이의 최적점을 찾아냈다.   

Gemini 3 Pro는 Gemini CLI와의 통합을 통해 개발자 경험을 혁신한다. 터미널 환경에서 직접 구동되는 Gemini 3 Pro는 복잡한 쉘 명령어를 생성하거나, 코드 리팩토링을 제안하고, 에러 로그를 분석하여 해결책을 제시하는 등 개발자의 워크플로우에 깊숙이 침투한다. 특히, 자연어 명령을 통해 복잡한 엔지니어링 작업을 자동화하는 ‘에이전틱 코딩(Agentic Coding)’ 기능은 개발 생산성을 획기적으로 향상시킬 잠재력을 지니고 있다.   

– Gemini 3 Deep Think: 심층 추론을 위한 전문화된 모드

Gemini 3 Deep Think는 Gemini 3.0 발표의 하이라이트이자, 가장 진보된 추론 능력을 보여주는 모델이다. 이 모델은 OpenAI의 o1 또는 o3 시리즈와 경쟁하는 포지셔닝을 가지며, 수학, 과학, 고난도 코딩과 같이 깊이 있는 사고가 필요한 영역에서 탁월한 성능을 발휘한다.   

  • 작동 메커니즘 (Thinking Tokens): Deep Think 모드는 답변을 생성하기 전에 ‘생각하는 토큰(Thinking Tokens)’을 생성하여 문제를 분해하고, 논리적 단계를 검증하며, 다양한 해결 경로를 탐색한다. 개발자는 API를 통해 thinkingLevel (Low/High)을 조절하거나 thinkingBudget을 설정하여 모델의 사고 깊이를 제어할 수 있다. 이는 비용과 응답 시간, 그리고 답변의 품질 사이에서 유연한 선택권을 제공한다.   
  • 성능 벤치마크: 초기 테스트 결과, Gemini 3 Deep Think는 박사급 지식을 요하는 GPQA Diamond 벤치마크에서 **93.8%**라는 경이적인 정답률을 기록했다. 또한, 매우 높은 난이도로 알려진 Humanity’s Last Exam에서도 도구 사용 없이 **41.0%**를 기록하며, 기존 모델들이 해결하지 못했던 영역에서의 가능성을 입증했다.   
  • 배포 전략: 현재 Deep Think 모드는 안전성 테스트를 거쳐 ‘Google AI Ultra’ 구독자와 일부 개발자들에게 순차적으로 공개될 예정이다. 이는 모델의 강력한 추론 능력이 오용될 가능성을 사전에 차단하고, 충분한 검증을 거치기 위한 신중한 접근으로 해석된다.   

Vibe Coding: 소프트웨어 개발의 새로운 패러다임

Gemini 3.0과 함께 구글이 제시한 **’Vibe Coding’**은 코딩의 민주화를 넘어, 개발의 본질을 재정의하는 개념이다. 이는 엄격한 구문(Syntax)과 로직 작성에 집중하던 전통적인 코딩 방식에서 벗어나, 자연어와 직관(Vibe)을 통해 소프트웨어를 ‘지휘’하는 방식으로의 전환을 의미한다.   

– Vibe Coding의 철학 및 워크플로우

Vibe Coding의 핵심 철학은 “인간은 의도를 정의하고, AI는 구현을 담당한다”는 것이다. 개발자가 자연어로 원하는 기능, 디자인 스타일, 작동 방식을 설명하면, Gemini 3.0은 이를 해석하여 실행 가능한 코드를 생성한다.

  • 반복적 정제 과정 (Iterative Refinement Loop):
    1. 목표 설정 (Describe): “모던한 디자인의 할 일 관리 앱을 만들어줘”와 같은 고수준의 프롬프트로 시작한다.
    2. 생성 (Generate): AI가 초기 코드와 프로젝트 구조를 생성한다.
    3. 실행 및 관찰 (Execute & Observe): 생성된 앱을 즉시 실행하여 결과를 확인한다.
    4. 피드백 (Refine): “버튼 색상을 파란색으로 바꾸고, 완료된 항목은 줄을 그어줘”와 같이 대화형으로 수정 사항을 지시한다.

이러한 과정은 Google AI Studio의 새로운 ‘Build’ 모드를 통해 구현된다. 사용자는 별도의 개발 환경 설정 없이 웹 브라우저 상에서 코드를 생성하고, 미리보기를 확인하며, Google Cloud Run을 통해 즉시 배포까지 완료할 수 있다.   

– Vibe Coding의 기술적 구현과 도구

Vibe Coding은 단순한 코드 자동 완성을 넘어선다. Gemini Code Assist와 같은 도구는 IDE 내에서 개발자의 의도를 파악하여 전체 함수를 작성하거나, 테스트 코드를 자동으로 생성하고, 복잡한 리팩토링을 수행한다. 또한, 사용자가 손으로 그린 UI 스케치나 에러가 발생한 화면의 스크린샷을 업로드하면, Gemini 3.0의 멀티모달 시각 능력을 활용하여 이를 코드로 변환하거나 버그의 원인을 분석해준다.   

이는 개발 진입 장벽을 획기적으로 낮출 뿐만 아니라, 숙련된 개발자들에게도 반복적인 코딩 작업에서 해방되어 아키텍처 설계나 비즈니스 로직과 같은 고부가가치 업무에 집중할 수 있는 기회를 제공한다. 실제로 초기 사용자들은 Vibe Coding을 통해 수일이 소요되던 프로토타이핑 작업을 몇 분 만에 완료하는 사례를 보고하고 있다.   

에이전틱 AI 생태계: Google Antigravity와 Gemini Agent

Gemini 3.0의 궁극적인 목표는 자율적으로 행동하는 에이전트(Agent)를 구축하는 것이다. 구글은 이를 위해 Google Antigravity라는 새로운 플랫폼을 선보였다.   

– Google Antigravity: 에이전트 개발의 중추

Google Antigravity는 개발자가 Gemini 3.0의 추론 능력과 도구 사용 능력을 활용하여 복잡한 에이전트 워크플로우를 설계하고 배포할 수 있는 통합 환경이다.

  • 자율적 도구 사용 (Autonomous Tool Use): Antigravity 기반의 에이전트는 단순히 텍스트를 생성하는 것을 넘어, 외부 API를 호출하고, 데이터베이스를 조회하며, 웹 브라우징을 수행하여 실질적인 작업을 완료한다. 예를 들어, “다음 주 도쿄 출장 일정을 잡아줘”라는 명령에 대해 항공권 검색, 호텔 예약, 캘린더 등록, 동료들에게 이메일 발송까지 스스로 수행할 수 있다.   
  • 엔터프라이즈 통합: Antigravity는 기업 환경에서의 사용을 염두에 두고 설계되었다. Vertex AI와의 연동을 통해 기업의 보안 정책을 준수하면서 사내 데이터를 활용하는 에이전트를 구축할 수 있으며, 이는 고객 서비스 자동화, 내부 문서 검색, 데이터 분석 등 다양한 업무 영역에 적용될 수 있다.   

– 소비자용 Gemini Agent의 진화

일반 사용자를 위한 Gemini 앱 또한 Gemini 3.0 기반의 에이전트 기능을 대폭 강화했다. Gemini Agent는 사용자의 이메일 보관함(Inbox)을 정리하거나, 복잡한 여행 계획을 수립하고, 쇼핑 리스트를 관리하는 등 개인 비서로서의 역할을 수행한다. 특히, 구글의 방대한 서비스(Gmail, Maps, Calendar, YouTube 등)와 긴밀하게 통합되어 있어, 사용자 데이터에 기반한 개인화된 서비스를 제공한다는 점에서 타 플랫폼 대비 강력한 경쟁 우위를 점한다.   

경쟁 모델 비교 분석: Gemini 3 vs. GPT-5.1 vs. Claude 3.7

2025년 하반기는 AI 기술 경쟁이 정점에 달한 시기이다. 구글의 Gemini 3, OpenAI의 GPT-5.1, Anthropic의 Claude 3.7이 거의 동시에 시장에 출시되면서 각 모델의 장단점과 특징이 뚜렷하게 드러나고 있다.   

– 벤치마크 성능 비교 (Technical Benchmarks)

다음은 주요 벤치마크 결과를 바탕으로 세 모델의 성능을 비교한 표이다.

평가 항목 (Benchmark)Gemini 3.0 (Deep Think / Pro)GPT-5.1 (Thinking / Instant)Claude 3.7 Sonnet (Extended Thinking)분석 및 시사점
GPQA Diamond (과학적 지식)93.8% (Deep Think)88.1%84.8%전문 지식과 심층 추론에서 Gemini 3 Deep Think가 가장 앞서 있음을 보여줌.
Humanity’s Last Exam (고난도 추론)41.0% (Deep Think)26.5%13.7%기존 벤치마크로 측정하기 어려운 초고난도 문제 해결 능력에서 Gemini 3가 압도적 우위를 점함.
SWE-bench Verified (코딩)54.9% (Deep Think)–70.3%순수 텍스트 기반 코딩 문제 해결 능력은 여전히 Claude 3.7이 강세를 보임. 단, Gemini는 멀티모달 코딩에 강점.
MathArena / MATH 500 (수학)23.4% (Apex High Score)–96.2% (MATH 500)수학적 문제 해결에서는 Claude 3.7과 OpenAI 모델들이 강력한 성능을 보임.
MMMU-Pro (멀티모달)81.0%–75% (MMMU)이미지, 비디오, 텍스트가 결합된 멀티모달 추론 능력은 Gemini 3가 독보적임.
LMArena Elo Rating1501––사용자 선호도를 반영하는 Elo 점수에서 Gemini 3 Pro가 역대 최고점을 기록하며 범용성을 입증.

– 모델별 특성 및 포지셔닝

  • Gemini 3.0: ‘멀티모달 추론의 제왕’. 텍스트뿐만 아니라 비디오, 코드, 이미지를 아우르는 복합적인 문제 해결에 가장 강력하다. 구글 생태계와의 통합, 100만 토큰의 컨텍스트 윈도우가 강점이다. Deep Think 모드는 과학 연구나 복잡한 분석 업무에 최적화되어 있다.
  • GPT-5.1: ‘대화형 AI의 완성형’. ‘Instant’ 모드를 통해 더 따뜻하고(Warmer tone) 인간적인 대화 스타일을 제공하며, 사용자 경험(UX) 측면에서 강점을 보인다. ‘Thinking’ 모드를 통해 추론 능력을 보완했으나, 순수 추론 깊이에서는 Gemini 3 Deep Think에 다소 밀리는 양상이다.   
  • Claude 3.7: ‘코딩 및 투명한 사고’. 개발자들 사이에서 가장 신뢰받는 코딩 모델(Code Assistant)로 자리 잡았다. ‘Extended Thinking’ 모드를 통해 사고 과정을 투명하게 보여주는 것이 특징이며, 엔지니어링 작업에서의 정밀도가 높다.   

최근 출시된, Gemini 3.0은 구글이 추구하는 범용 인공지능(AGI)으로 가는 여정에서 가장 강력하고 실질적인 도약이다. 기업과 개인은 이 새로운 도구를 어떻게 업무 프로세스에 통합하고, 새로운 비즈니스 기회를 포착할 것인지에 대한 전략적 고민을 시작해야 할 시점이다. Gemini 3.0이 가져올 변화는 이제 막 시작되었으며, 그 파급력은 우리가 상상하는 것 이상일 것이다.

아이폰에서 드디어 교통카드 사용이 가능

오랫동안 아이폰 사용자들의 숙원이었던 교통카드 기능이 마침내 실현되었습니다. 2025년 7월부터 한국에서도 Apple Wallet(지갑) 앱에 티머니 교통카드를 추가하여, 실물 카드 없이 아이폰 또는 애플 워치만으로 지하철, 버스 등 대중교통을 이용할 수 있게 되었습니다. 서울을 비롯한 대한민국 전역의 지하철 및 버스 대부분에서 아이폰을 태그하여 승차할 수 있으며, 편의점 등 티머니 가맹점에서도 결제 수단으로 사용할 수 있습니다

아이폰과 애플 워치에 추가된 Apple Pay 티머니 카드 화면. iPhone이나 Watch만 가볍게 태그하면 전국 대중교통을 이용할 수 있다.

애플페이 티머니 개요 및 장점

오랫동안 아이폰 사용자들의 숙원이었던 교통카드 기능이 마침내 실현되었습니다. 2025년 7월부터 한국에서도 Apple Wallet(지갑) 앱에 티머니 교통카드를 추가하여, 실물 카드 없이 아이폰 또는 애플 워치만으로 지하철, 버스 등 대중교통을 이용할 수 있게 되었습니다. 서울을 비롯한 대한민국 전역의 지하철 및 버스 대부분에서 아이폰을 태그하여 승차할 수 있으며, 편의점 등 티머니 가맹점에서도 결제 수단으로 사용할 수 있습니다

애플페이 티머니는 **익스프레스 모드(Express Mode)**를 지원하여, 아이폰을 잠금 해제하거나 앱을 실행할 필요 없이 단말기에 가까이 대기만 하면 자동으로 결제가 이루어집니다. 심지어 아이폰 배터리가 완전히 방전된 후에도 최대 5시간까지 교통카드 기능을 사용할 수 있는 전원 절약 모드도 지원됩니다. 잔액 확인 및 충전도 아이폰의 지갑 앱에서 바로 가능하고, 자동 충전 기능을 통해 잔액 부족 걱정 없이 이용할 수 있다는 편리함이 있습니다. 아래에서는 Apple Pay 기반 티머니 카드의 등록 방법부터 사용법, 충전 방법, 이용 가능 지역/교통수단, 그리고 실물 카드 대비 장단점까지 차례로 알아보겠습니다.

애플페이 티머니 등록 절차

아이폰에서 티머니 교통카드를 사용하려면, 우선 Apple 지갑 앱에 티머니 카드를 추가해야 합니다. 절차는 다음과 같습니다:

  1. 지원 기기 및 iOS 버전 확인: 아이폰 XS/XR 이후 모델이고 iOS 17.2 이상(애플 워치는 Series 6 이상에 watchOS 10.2 이상)이어야 합니다. 구형 기기는 지원되지 않으니 유의하세요. 또한 선불형 티머니 카드만 추가 가능하며(후불 교통카드는 미지원), 아이폰과 애플 워치에 각각 별도로 카드 발급이 필요합니다.
  2. 지갑 앱에서 카드 추가: 아이폰의 Wallet (지갑) 앱을 열고 “+” (추가) 버튼을 탭합니다. 메뉴에서 **“교통 카드”**를 선택하고 **“Tmoney”**를 고르면, 화면 안내에 따라 새로운 티머니 교통카드를 발급할 수 있습니다. 이때 최소 충전 금액을 설정하라는 안내가 나오며, 초기 등록을 위해 일정 금액을 충전해야 합니다. 원하는 금액을 애플페이를 통해 결제하면 티머니 카드가 지갑에 추가됩니다. 발급과 충전에 국내 발급 신용/체크카드 (애플페이에 등록된 카드) 가 필요합니다. 현재(2025년 7월) 애플페이에서 지원되는 국내 카드사가 제한적이므로, 현대카드 등 애플페이 등록 카드가 있어야 이 방법으로 충전까지 완료할 수 있습니다.
  3. 모바일 티머니 앱 이용 (대안): 만약 현대카드 등 애플페이 가능 카드가 없다면, 모바일 티머니 iOS 앱을 통해 우회할 수 있습니다. App Store에서 “모바일 티머니” 앱을 최신 버전으로 설치/업데이트한 뒤 실행하고, 앱 내에서 모바일 티머니 카드를 새로 발급합니다. 발급된 카드에 다른 신용/체크카드나 계좌이체 등으로 충전한 다음, 해당 티머니 카드를 아이폰 지갑에 추가하면 됩니다. 이렇게 하면 현대카드가 없어도 아이폰에 충전된 티머니 카드를 사용할 수 있습니다. 다만 이 방식은 별도의 앱 설치와 본인 인증 절차가 필요하며, 충전 수단에 따라 일부 수수료가 부과될 수 있습니다

Tip: 애플 워치에서도 티머니를 쓰고 싶다면, 아이폰에서 티머니 카드를 발급한 후 Watch 앱의 “지갑 및 Apple Pay” 설정으로 들어가 애플 워치에 티머니 카드 추가를 진행해야 합니다. 아이폰에 추가한 카드가 자동으로 워치에 동기화되는 것은 아니므로, 워치용으로 별도 발급·추가하세요

지갑 앱에서의 사용 방법

일단 지갑 앱에 티머니 교통카드를 추가했다면, 사용 방법은 기존 실물 티머니 카드와 거의 동일합니다. 아이폰이나 애플 워치로 지하철 개찰구 단말기나 버스 단말기에 가져다 대기만 하면 결제됩니다. 익스프레스 모드 덕분에 별도의 Face ID 인증이나 화면 켜기도 필요 없으며, 잠긴 화면 상태에서도 태그만으로 인식됩니다. 태그 시 진동/소리와 함께 화면 상단에 티머니 카드 이미지와 잔액 변동 등이 잠깐 표시되어, 성공적으로 결제되었는지 확인할 수 있습니다. 애플 워치 역시 화면을 켤 필요 없이 단말기에 가까이 대면 진동 피드백과 함께 승차가 완료됩니다.

잔액 확인 및 이용 내역: 아이폰의 지갑 앱에서 티머니 카드를 선택하면 현재 잔액이 표시됩니다. 카드를 아래로 스크롤하면 최근 거래 내역도 확인할 수 있어, 언제 어디서 얼마나 사용했는지 볼 수 있습니다

또한 티머니 카드 우측 상단의 “⦁⦁⦁” 버튼을 탭하면 카드 세부 설정 메뉴가 열리며, 여기서 자동 충전 설정이나 카드 삭제, 익스프레스 모드가 활성화 여부 등을 관리할 수 있습니다. 참고로 애플페이 티머니는 기본적으로 첫 추가 카드에 익스프레스 모드가 자동 활성화되며, 만약 티머니 카드를 여러 장 추가한 경우 하나만 Express로 설정되고 나머지는 수동 선택해야 사용 가능합니다.

오프라인 결제: 티머니 카드는 대중교통 외에도 편의점, 택시 등 티머니 가맹점에서 소액결제 수단으로 사용할 수 있습니다. 결제 시 “티머니로 결제할게요”라고 말한 뒤 아이폰을 리더기에 태그하면, 교통카드 잔액에서 금액이 차감되어 결제됩니다. 이때도 대체로 익스프레스 모드로 인식되지만, 일부 단말기에서는 인식이 다소 지연되거나 실패할 수 있으니, 화면에 표시되는 완료 여부를 확인하는 것이 좋습니다.

저전력 모드: 아이폰 배터리가 부족한 경우에도 최대 5시간까지는 교통카드 기능이 유지됩니다. 배터리가 0%로 꺼진 상태에서 교통카드를 태그하면, 전원 절약 모드로 잔여 시간 동안 결제가 가능하므로 긴급한 상황에서 유용합니다. 다만 5시간이 지나 완전히 방전된 경우나 기기를 분실한 경우를 대비해 예비용 실물 카드를 소지하거나, 애플 워치를 함께 활용하는 것도 안전한 방법입니다.

충전 및 자동 충전 방법 (지원 결제 수단)

애플페이 티머니 카드는 충전식(선불) 교통카드이므로, 잔액이 충분해야 사용할 수 있습니다. 충전하는 방법은 여러 가지가 있으며, 지원되는 결제 수단에도 차이가 있습니다. 주요 충전 방법과 특징은 아래 표와 같습니다:

충전 방법특징 및 결제 수단
지갑 앱 직접 충전애플 Wallet 앱에서 티머니 카드 선택 후 “충전” 메뉴 사용. 애플페이에 등록된 국내 발급 신용/체크카드로 결제되어 즉시 충전됨. 수수료 없이 즉시 충전 가능하지만, 현재 국내에서 애플페이를 지원하는 카드사(예: 현대카드)에 한해 이용 가능.
모바일 티머니 앱 충전티머니 공식 앱에서 충전 금액 선택 후 다양한 결제 수단 사용 가능. 애플페이에 등록되지 않은 다른 신용/체크카드, 계좌이체, 간편결제 등을 통해 충전할 수 있음. 일부 결제 수단은 소액결제 수수료 (~2%)가 붙을 수 있으며, 충전 후 해당 금액이 지갑의 티머니 카드에 반영된다.
오프라인 충전편의점(CU, GS25 등)이나 지하철 자동충전기 에서 현금으로 충전. 아이폰의 티머니 카드를 리더기에 태그하여 실물 카드처럼 충전할 수 있다. 편의점은 점포마다 지원 여부가 다를 수 있고, 지하철 무인 충전기는 수수료 없이 이용 가능.

충전한 금액은 즉시 티머니 카드 잔액에 반영되며, 충전 최대 한도는 50만 원입니다 (실물 카드와 동일). Apple 지갑에서의 자동 충전 기능도 세계 최초로 도입되었는데, 이를 활용하면 잔액이 일정 금액 이하로 내려갈 때 미리 설정한 금액만큼 자동으로 충전됩니다. 지갑 앱의 카드 설정에서 **“자동 충전”**을 켜고 *기준 잔액 (예: 5,000원 이하)*과 *충전 금액 (최소 1만 원~)*을 지정하면, 이후부터는 잔액이 부족해도 자동으로 카드에 금액이 추가됩니다. 예를 들어 잔액 7,000원 이하로 떨어지면 20,000원을 자동충전하도록 설정해 두면 출퇴근 시 잔액 부족으로 곤란을 겪을 일이 사라집니다. 자동충전 시 결제되는 카드 역시 애플페이에 등록된 국내 신용카드로 한정되며, 현재로선 현대카드로 설정하는 경우가 많습니다. 자동 충전 설정/변경은 지갑 앱이나 티머니 앱 양쪽에서 모두 가능합니다.

2025년 7월 현재 애플페이 국내 서비스는 현대카드 단독으로 제공되고 있습니다. 지갑 앱에서 티머니를 충전하거나 자동충전을 이용하려면 현대카드처럼 애플페이에 등록된 국내 카드가 반드시 필요합니다. 현대카드가 없는 경우 앞서 언급한 티머니 앱 충전 또는 오프라인 충전 방식을 이용해야 합니다. 추후 신한카드, KB국민카드 등 다른 카드사의 애플페이 지원이 확대되면 지갑 앱 충전도 더 자유로워질 것으로 기대됩니다.

티머니 사용 가능 지역 및 교통수단

애플페이 티머니 카드는 기존 실물 티머니 교통카드와 동일한 범위에서 사용 가능합니다. 즉, 티머니로 결제할 수 있는 대부분의 교통수단에서는 아이폰 교통카드로도 이용이 가능하다는 뜻입니다. 수도권부터 지방까지 폭넓게 활용되지만, 일부 제한 사항도 있으므로 상세 내용을 정리하면 다음과 같습니다:

교통수단티머니 사용 범위
지하철서울·경기 수도권 전철 (1~9호선, 신분당선, 공항철도 등 모든 노선), 인천 지하철 1~2호선, 부산 1~4호선, 대구 1~3호선, 대전 1호선, 광주 1호선 등 전국 도시철도에서 사용 가능
시내버스서울, 경기, 인천 등 수도권 전 지역의 시내버스 및 부산·대구·광주·대전·울산 등 광역시 버스, 그 외 강원·충청·경상·전라 대부분 지역의 시내·농어촌 버스까지 지원. 거의 전국 모든 도시에서 현금 대신 티머니로 버스 요금을 낼 수 있습니다.
택시서울 및 수도권 전체, 6대 광역시, 그리고 대부분 기초지자체의 택시에서 티머니 결제 가능. 다만 일부 지방의 구형 단말기 택시는 티머니 결제를 지원하지 않을 수 있습니다.
시외버스시외버스(광역버스) 요금 결제는 티머니 지원되지 않음. 고속도로를 이용하는 시외/고속버스의 터미널 현장 구매나 모바일 예매는 티머니로 불가능합니다.
고속버스일부 고속버스 노선 한정으로 티머니 결제가 지원됨. (예: 금호고속, 동양고속, 중앙고속 등 일부 회사). 해당 고속버스 터미널 매표소에서 티머니로 승차권을 구매할 수 있습니다.
철도(KTX 등)코레일에서 운행하는 KTX, ITX-새마을, 무궁화호 등 열차 승차권 구매에도 티머니 사용 가능. 자동발매기에서 티머니로 결제하여 승차권을 살 수 있습니다. (※ SRT는 별도 카드 필요)

요약하면, “티머니” 마크가 붙어 있는 거의 모든 교통수단에서 아이폰 티머니도 사용할 수 있다고 보면 됩니다. 실제로 기자 실험에 따르면, 아이폰에 추가한 티머니 카드로 서울 시내버스를 승차한 결과 1500원 요금이 정상 차감되며 실물 카드와 동일하게 동작했습니다. 단, 일부 시외버스와 일부 지역의 택시를 제외하고는 문제없이 이용 가능하나, 혹시 모를 단말기 미지원에 대비해 승차 전 티머니 결제여부를 미리 확인해보는 것이 좋습니다. 현재는 청소년 우대용 티머니나 기후동행카드/K패스 등 특수 할인 교통카드는 지원되지 않으므로(등록 불가), 해당 할인 혜택을 받으려면 아직 실물 카드를 이용해야 합니다.

실물 카드 대비 디지털 티머니의 장단점

스마트폰 속으로 들어온 디지털 티머니는 여러모로 편리하지만, 기존 실물 티머니 카드와 비교했을 때 장점과 단점이 있습니다. 이를 정리하면 다음과 같습니다:

디지털 티머니의 주요 장점

  • 휴대 편의성: 지갑이나 카드 케이스를 들고 다닐 필요 없이 항상 소지하는 아이폰만으로 교통카드를 이용할 수 있습니다. 실물 카드 분실 위험도 사라집니다. 또한 아이폰과 애플 워치를 연동하면 손목만으로도 결제되는 등 일상 이동이 한층 간편해집니다.
  • **손쉬운 **충전 및 관리: 아이폰에서 언제든지 잔액 확인과 충전을 할 수 있어 편의점이나 역무기기 앞에서 번거롭게 충전할 필요가 없습니다. 자동 충전을 켜두면 잔액이 부족할 틈 없이 늘 일정 금액이 유지되어 안심입니다. 이 모든 충전 과정에 수수료가 없고(애플페이 충전 시) 매우 즉각적으로 처리가 됩니다.
  • 보안 및 분실 대처: 애플페이 티머니는 Secure Element 칩을 통해 카드 정보를 안전하게 저장하고, 개인의 이용 내역을 애플이나 티머니가 추적할 수 없습니다. 기기를 분실하였을 경우 나의 찾기(Find My) 앱을 통해 원격으로 아이폰을 분실 모드로 전환하거나 티머니 카드를 즉시 사용 중지할 수 있어, 실물 카드를 잃어버렸을 때보다 보안 대응이 용이합니다.
  • 빠른 태그 인식: 실제 사용 후기에 따르면 아이폰의 티머니 인식 속도는 매우 빨라 지하철 개찰구나 버스 단말기에서 실물 카드와 동일하게 즉시 인식됩니다. 특히 최신 교통 단말기와의 호환성이 좋아 쾌적하게 이용할 수 있습니다. (※ 다만 일부 구형 단말기는 인식이 살짝 지연될 수 있다고 보고됨)
  • 추가 기능: 모바일 티머니 앱과 연동하여 티머니 마일리지 적립이나, 어린이/청소년 할인 설정 같은 부가 기능을 활용할 수 있습니다. 예를 들어 모바일 티머니 앱에서 해당 연령으로 등록하면 디지털 티머니 카드에도 청소년/어린이 교통할인 요금이 적용됩니다. (실물 할인카드는 별도 발급 절차가 필요한 반면, 모바일에서는 비교적 간편하게 설정 가능.)

디지털 티머니의 단점 및 유의사항

  • 초기 설정 및 조건: 애플페이 지원 아이폰 (iPhone XS, XR 이후 모델) 이면서 iOS 17.4 이상이 설치되 있어있어야 하고, 국내 발급 카드가 애플페이에 등록되어 있어야 티머니 충전이 가능합니다. 특히 외국인 관광객의 경우 국내 신용카드가 없으면 아이폰에 티머니를 충전할 방법이 없어 사실상 사용이 불가능합니다. (일본의 Suica처럼 해외 카드로 바로 충전되지 않는 점이 아쉬운 부분입니다.) 현재 티머니 측에서도 외국인 관광객도 사용할 수 있는 방안을 검토 중이라고 하나, 아직까지는 한국 거주자 위주의 서비스임을 참고해야 합니다.
  • 특수 할인/후불 기능 미지원: 앞서 언급했듯 후불형 티머니 카드 (신용카드 연계 교통결제)나 정기권/KPass/기후동행카드 등의 특수 기능은 디지털 티머니에서 지원되지 않습니다. 따라서 해당 할인 혜택을 받기 위해서는 실물 카드(또는 별도 앱)을 그대로 사용해야 합니다. 또한 현재 일부 티머니 선불카드의 잔액 이전도 직접적으로 할 수 없어, 기존 카드 잔액을 모바일로 옮기려면 번거로운 환불 절차나 마일리지 전환을 거쳐야 하는 불편도 있습니다.
  • 기기별 개별 카드: 아이폰과 애플 워치를 둘 다 사용하는 경우 각 기기에 별도의 티머니 카드를 발급해야 합니다. 하나의 교통카드를 두 기기가 공유하지 못하므로, 두 장의 카드에 잔액을 각각 관리해야 합니다. 예를 들어 아이폰과 워치에 각각 5천 원씩 충전되어 있다면 한쪽을 다 쓰더라도 다른 쪽 잔액을 합쳐 쓸 수는 없습니다. 이 부분은 다소 비효율적일 수 있는데, 추후 아이클라우드 연동 등을 통한 개선이 기대됩니다.
  • 기타 사항: 디지털 티머니는 초기 발급 시 최소 충전금액 부담(보통 1만원 내외 권장) 정도가 있으며, 실물 카드(통상 2,500원 구매) 대비 카드 발급 자체 비용은 없으나 충전 자금은 선불로 잡아두어야 합니다. 또한 아주 드물게 티머니 결제가 지원되지 않는 터미널이나 오류 상황이 있을 수 있으므로, 중요한 출퇴근시에 대비해 잔액 부족 알림을 켜두거나(자동충전 활용) 예비 수단을 준비하는 것이 좋습니다.

애플페이 도입은 아이폰 사용자들에게 큰 편의를 가져다주었습니다. 아직 몇 가지 제약 사항이 남아있지만, 향후 더 많은 카드사의 애플페이 참여와 외국인 이용 지원, 후불 기능 등이 확충 된다면 더욱 완성도 높은 서비스가 될 것으로 보입니다. 지금까지 실물 교통카드를 들고 다녔던 아이폰 사용자라면, 빠르고 편리한 애플페이 교통카드 기능을 꼭 사용해보시기 바랍니다.